
JDBC로 CRUD 구현하기와 커넥션 풀, DataSource
순수 JDBC로 CRUD를 구현하며 커넥션과 리소스 정리를 이해하고, 커넥션 풀과 DataSource로 개선한다.
시리즈 · Spring10 / 14
- SOLID 원칙과 OCP·DIP를 지키는 방법
- 의존성 주입(DI)과 스프링 컨테이너
- 쓰레드 풀과 싱글톤 서블릿의 동시성 문제
- FrontController 패턴과 핸들러 어댑터로 스프링 MVC 구조 이해하기
- @ModelAttribute와 PRG 패턴으로 폼 요청 처리하기
- System.out 대신 SLF4J로 로그 남기기
- 세션 직접 만들어 보기와 HttpSession
- 스프링 인터셉터와 예외 발생 시 오류 페이지 흐름
- 서블릿 Part와 MultipartFile로 파일 업로드 처리하기
- JDBC로 CRUD 구현하기와 커넥션 풀, DataSource
- JDBC 트랜잭션에서 스프링 트랜잭션 동기화와 트랜잭션 AOP까지
- JPA 변경 감지(dirty checking)와 병합(merge)
- 서블릿 컨테이너 초기화와 스프링 컨테이너 등록 과정
- 싱글톤 빈의 동시성 문제와 ThreadLocal
JDBC
JDBC(Java Database Connectivity)는 자바에서 데이터베이스에 접속할 수 있게 해 주는 표준 API다. 데이터베이스마다 연결 방법과 SQL을 주고받는 방식이 달라서, JDBC가 표준 인터페이스를 정의하고 각 DB 벤더가 이를 구현한 JDBC 드라이버를 제공한다. 애플리케이션은 DB 종류와 관계없이 같은 방법으로 접근할 수 있다.
java.sql.Connection: 연결java.sql.Statement: SQL을 담은 내용java.sql.ResultSet: SQL 요청의 응답
JDBC를 직접 쓰는 대신 편리하게 사용하도록 돕는 기술이 있다.
- SQL Mapper (Spring JdbcTemplate, MyBatis): JDBC의 반복 코드를 줄여 준다. SQL은 개발자가 직접 작성해야 하지만 비교적 쉽게 배울 수 있다.
- ORM (JPA, 하이버네이트): 객체를 관계형 데이터베이스 테이블과 매핑해 준다. SQL을 직접 작성하지 않아도 되지만 학습 난이도가 높다.
어떤 기술을 쓰든 밑바닥에서는 JDBC가 동작한다.
JDBC CRUD
H2 데이터베이스를 사용했다.
public abstract class ConnectionConst {
    public static final String URL = "jdbc:h2:tcp://localhost/~/test";
    public static final String USERNAME = "sa";
    public static final String PASSWORD = "";
}
저장
public Member save(Member member) throws SQLException {
    String sql = "insert into member(member_id, money) values (?, ?)";

    Connection con = null;
    PreparedStatement pstmt = null;

    try {
        con = DBConnectionUtil.getConnection();
        pstmt = con.prepareStatement(sql);
        pstmt.setString(1, member.getMemberId());
        pstmt.setInt(2, member.getMoney());
        pstmt.executeUpdate();
        return member;
    } catch (SQLException e) {
        log.error("db error", e);
        throw e;
    } finally {
        close(con, pstmt, null);
    }
}getConnection(): DB와 연결한다.prepareStatement(sql): 실행할 SQL을 준비한다.?를 통한 파라미터 바인딩을 사용하면 입력값이 SQL 구문이 아닌 데이터로만 취급되므로 SQL Injection을 예방할 수 있다.executeUpdate(): SQL을 실행하고 영향받은 row 수를 반환한다.
DB와는 TCP/IP 커넥션으로 연결되어 있으므로 사용이 끝난 리소스는 반드시 닫아야 한다. 이때 Statement를 닫다가 예외가 발생하면 Connection을 닫는 코드가 실행되지 않을 수 있으므로, 리소스마다 따로 예외를 처리한다.
private void close(Connection con, Statement stmt, ResultSet rs) {
    if (rs != null) {
        try {
            rs.close();
        } catch (SQLException e) {
            log.error("error", e);
        }
    }

    if (stmt != null) {
        try {
            stmt.close();
        } catch (SQLException e) {
            log.error("error", e);
        }
    }

    if (con != null) {
        try {
            con.close();
        } catch (SQLException e) {
            log.error("error", e);
        }
    }
}
조회
public Member findById(String memberId) throws SQLException {
    String sql = "select * from member where member_id = ?";
    Connection con = null;
    PreparedStatement pstmt = null;
    ResultSet rs = null;

    try {
        con = getConnection();
        pstmt = con.prepareStatement(sql);
        pstmt.setString(1, memberId);

        rs = pstmt.executeQuery();
        if (rs.next()) {
            Member member = new Member();
            member.setMemberId(rs.getString("member_id"));
            member.setMoney(rs.getInt("money"));
            return member;
        } else {
            throw new NoSuchElementException("member not found memberId=" + memberId);
        }
    } catch (SQLException e) {
        log.error("db error", e);
        throw e;
    } finally {
        close(con, pstmt, rs);
    }
}
데이터를 변경하지 않는 조회는 executeQuery()를 사용하고, 실행 결과는 ResultSet에 담긴다. ResultSet은 내부의 커서로 데이터를 조회하는데, 최초의 커서는 데이터를 가리키고 있지 않다. 그래서 rs.next()를 최소 한 번은 호출해야 한다. 다음 데이터가 없으면 rs.next()는 false를 반환한다.
수정과 삭제는 저장과 구조가 같으므로 생략한다.
테스트
@Slf4j
class MemberRepositoryV0Test {

    MemberRepositoryV0 repository = new MemberRepositoryV0();

    @Test
    void crud() throws SQLException {
        // save
        Member member = new Member("memberV5", 10000);
        repository.save(member);

        // findById
        Member findMember = repository.findById(member.getMemberId());
        Assertions.assertThat(findMember).isEqualTo(member);

        // update: money 10000 -> 20000
        repository.update(member.getMemberId(), 20000);
        Member updateMember = repository.findById(member.getMemberId());
        Assertions.assertThat(updateMember.getMoney()).isEqualTo(20000);

        // delete
        repository.delete(member.getMemberId());
        Assertions.assertThatThrownBy(() -> repository.findById(member.getMemberId()))
                .isInstanceOf(NoSuchElementException.class);
    }
}findMember와member는 서로 다른 인스턴스지만isEqualTo가 통과한다. Lombok의@Data가equals,hashCode를 오버라이딩해 주기 때문이다.- 삭제 검증은 삭제된 회원을 조회할 때
NoSuchElementException이 발생하는지로 확인한다.
여기까지 구현하면 두 가지 문제가 보인다. SQL을 실행할 때마다 커넥션을 새로 만든다는 점, 그리고 try-catch-finally 코드가 메서드마다 반복된다는 점이다. 먼저 커넥션 문제부터 해결한다.
커넥션 풀
JDBC만 사용하면 SQL을 실행할 때마다 DB 드라이버가 DB와 TCP/IP 커넥션을 새로 맺는다. 이 과정에서 3-way handshake 같은 네트워크 동작이 발생하는데, 과정이 복잡하고 시간이 걸려 응답 속도에 악영향을 준다.
커넥션 풀은 DB와의 커넥션을 미리 만들어 풀에 보관해 두고, 필요할 때 꺼내 쓰고 반납하는 방식이다.
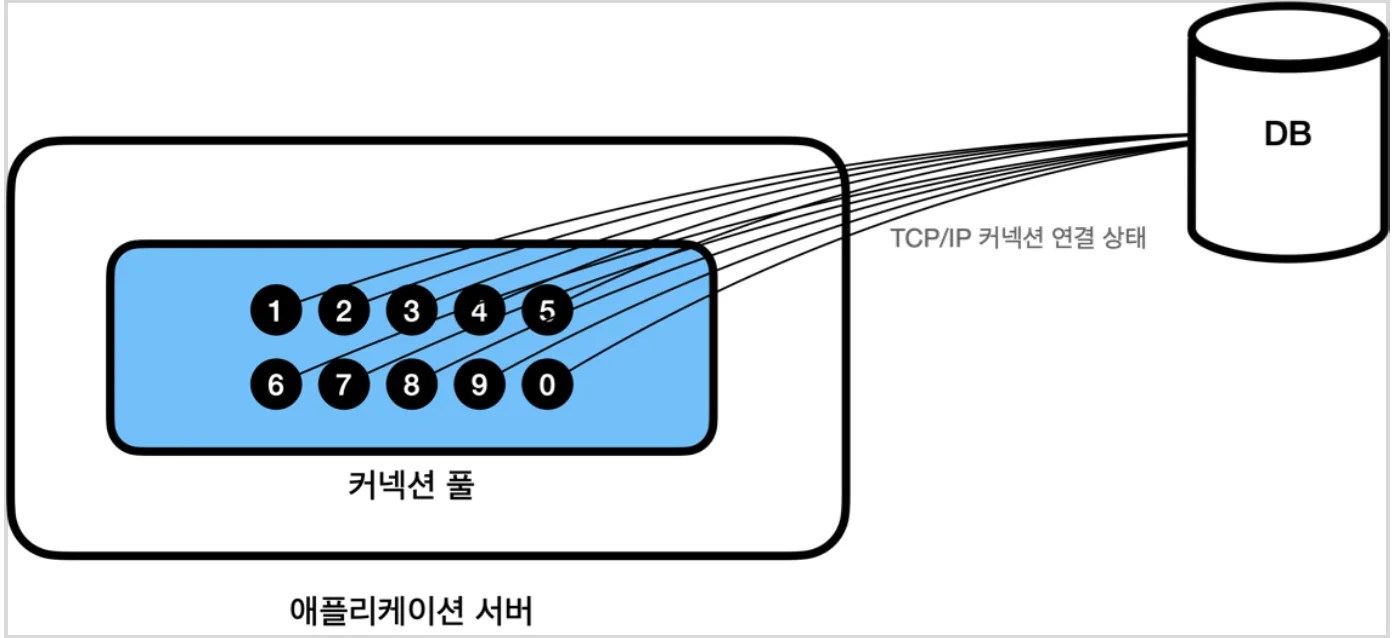
커넥션 풀 오픈소스는 여러 가지가 있지만 주로 HikariCP를 사용한다.
DataSource
DriverManager로 매번 새로 연결하든 HikariCP 풀에서 꺼내든, 애플리케이션 입장에서는 커넥션을 얻는다는 점이 같다. 자바는 이렇게 커넥션을 획득하는 방법을 추상화한 DataSource 인터페이스를 제공한다.
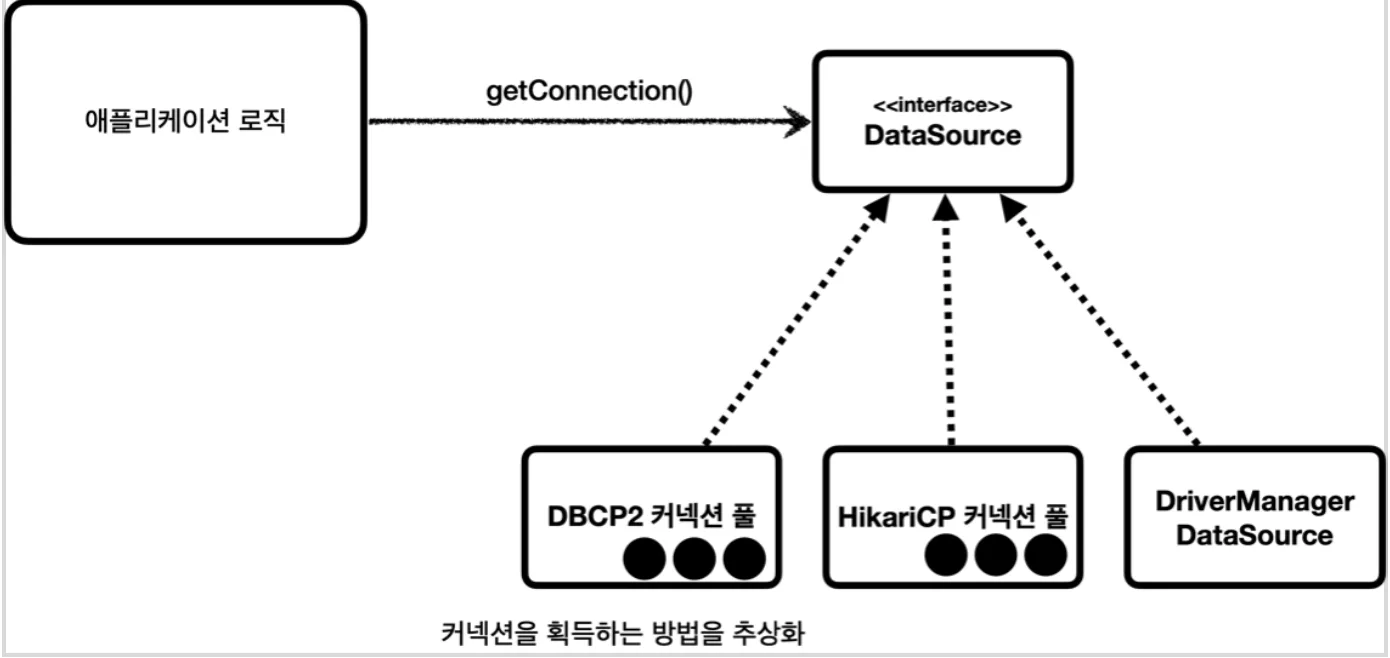
DataSource 적용
리포지토리는 DataSource를 주입받아 커넥션을 얻는다. URL, USERNAME, PASSWORD 같은 설정은 DataSource를 만들 때 한 번만 넣으면 되고, 사용하는 쪽은 getConnection()만 호출한다. 설정과 사용이 분리된다.
@Slf4j
public class MemberRepositoryV1 {

    private final DataSource dataSource;

    public MemberRepositoryV1(DataSource dataSource) {
        this.dataSource = dataSource;
    }

    // ... CRUD ...

    private Connection getConnection() throws SQLException {
        Connection con = dataSource.getConnection();
        log.info("get connection={}, class={}", con, con.getClass());
        return con;
    }

    private void close(Connection con, Statement stmt, ResultSet rs) {
        JdbcUtils.closeResultSet(rs);
        JdbcUtils.closeStatement(stmt);
        JdbcUtils.closeConnection(con);
    }
}
앞에서 try-catch로 길게 작성했던 close도 스프링이 제공하는 JdbcUtils의 편의 메서드로 간단해진다.
구현체 교체
@Slf4j
class MemberRepositoryV1Test {

    MemberRepositoryV1 repository;

    @BeforeEach
    void beforeEach() {
        // 매번 새 커넥션을 생성
        // DriverManagerDataSource dataSource = new DriverManagerDataSource(URL, USERNAME, PASSWORD);

        // 커넥션 풀링
        HikariDataSource dataSource = new HikariDataSource();
        dataSource.setJdbcUrl(URL);
        dataSource.setUsername(USERNAME);
        dataSource.setPassword(PASSWORD);

        repository = new MemberRepositoryV1(dataSource);
    }
}HikariDataSource도 DataSource의 구현체이므로, DriverManagerDataSource에서 커넥션 풀로 바꿔도 리포지토리 코드는 수정할 필요가 없다. DI와 OCP가 주는 이점이다.
정리하면, 커넥션 풀로 SQL을 실행할 때마다 DB와 새로 연결하는 비용을 없앴고, DataSource로 커넥션 획득 방법을 추상화해 리포지토리와 구체적인 커넥션 기술 사이의 의존을 느슨하게 만들었다.
참고
- 김영한, 스프링 DB 1편 - 데이터 접근 핵심 원리 (인프런)