
서버/인프라를 지탱하는 기술 Ch.4 — 부하 그리고 Load Average
서버/인프라를 지탱하는 기술 4장을 바탕으로 Load Average의 의미와 한계, CPU·I/O 부하를 구분해 병목을 찾는 방법을 정리한다.
시리즈 · DevOps 서적3 / 5
- 서버/인프라를 지탱하는 기술 Ch.1 — 다중화와 부하분산의 기본
- 서버/인프라를 지탱하는 기술 Ch.2 — 리버스 프록시를 도입하는 이유
- 서버/인프라를 지탱하는 기술 Ch.4 — 부하 그리고 Load Average
- 시스템 성능 엔지니어링 Ch.1~2 — 소개와 방법론
- 시스템 성능 엔지니어링 Ch.4 — 관측 가능성 도구와 모니터링 S/W의 본질
『서버/인프라를 지탱하는 기술』 4장의 내용과 Load Average에 대해 정리한다.
단일 서버의 성능부터
서버 1대로 처리할 수 있는 부하를 10대 이상으로 분산하고 있다면 분산의 목적을 제대로 이루지 못한 것이다. 먼저 단일 서버의 성능을 충분히 끌어낸 다음에 서버 추가를 고민해야 한다.
단일 호스트의 성능을 끌어내려면 서버 리소스의 이용 현황을 정확히 파악해야 한다. MySQL 같은 애플리케이션의 부하를 먼저 떠올리기 쉽지만, 살펴볼 대상은 그 하위에 있는 OS다. 부하를 알기 위해 필요한 정보는 모두 리눅스 커널이 갖고 있고, ps, top, sar 같은 도구로 볼 수 있다.
핵심은 원인을 추측하지 말고 계측하라는 것이다.
Load Average와 부하
Load Average란
- CPU와 디스크 I/O가 얼마나 바쁜지를 나타내는 지표이다.
- 평균적으로 어느 정도의 Task가 대기 상태로 있었는지를 1분, 5분, 15분 평균값으로 보고한다.
- 커널이 Timer Interrupt를 통해 주기적으로 계산한다.
top,uptime명령으로 확인할 수 있다.
값은 CPU 코어 수를 기준으로 해석한다. 코어 하나가 100% 로드되면 1이므로, 1코어에서는 1, 2코어에서는 2가 꽉 찬 상태다. 1코어에서 Load Average가 2라면 Task 하나는 실행 중이고 그만큼의 Task가 더 대기하고 있다는 의미다.
부하란
부하는 여러 Task가 서버 리소스를 쟁탈한 결과로 생기는 대기 시간이다. 크게 CPU 부하와 I/O 부하로 나뉜다.
프로세스 스케줄러가 관리하는 프로세스 상태 중 Load Average와 관련된 것은 다음과 같다.
| 상태 | 의미 | Load Average 포함 |
|---|---|---|
TASK_RUNNING (R) |
실행 중이거나 실행 가능한 상태 | 포함 |
TASK_UNINTERRUPTIBLE (D) |
디스크 입출력 대기, 중단 불가능 | 포함 |
TASK_INTERRUPTIBLE |
키보드 입력 대기 등, 중단 가능 | 미포함 |
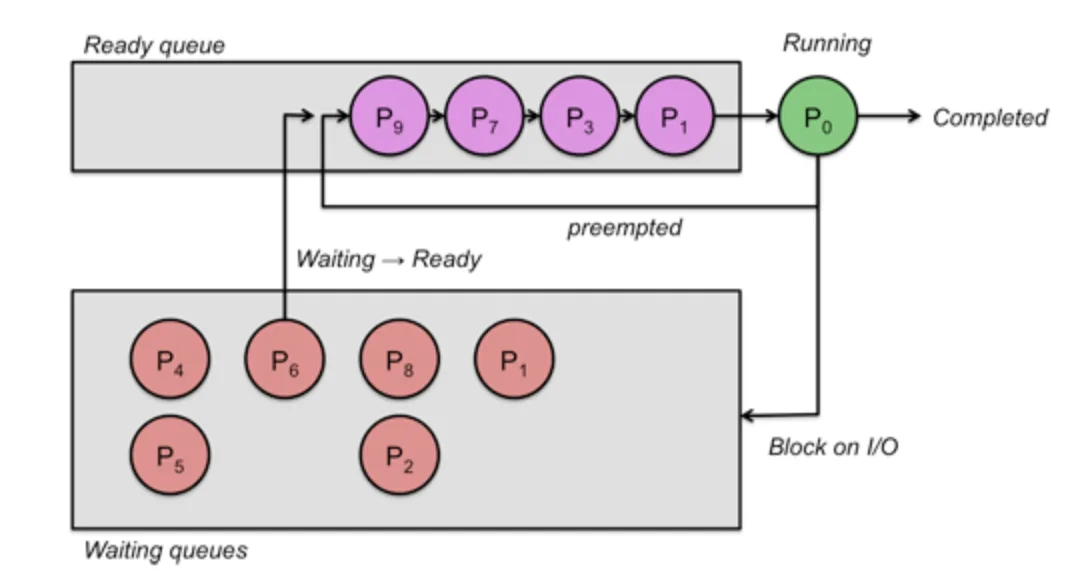
- Ready queue: CPU 실행 권한이 부여되기를 기다리는 프로세스
- Waiting queue: I/O가 완료되기를 기다리는 프로세스
프로세스 입장에서는 요청에 대한 응답이 올 때까지 아무것도 할 수 없다. 이렇게 기다리는 프로세스가 많다는 것이 곧 부하이고, Load Average 계산에 포함된다. 반면 TASK_INTERRUPTIBLE처럼 사용자의 입력을 기다리는 경우는 시스템이 바빠서 기다리는 것이 아니므로 포함되지 않는다.
Load Average의 한계
Load Average는 어디까지나 대기 Task의 수만을 나타낸다. 이 값만으로는 CPU 부하가 높은지, I/O 부하가 높은지 판단할 수 없다. sar로 CPU 사용률(%user, %system)과 I/O 대기율(%iowait)을 나눠서 봐야 한다.
멀티 CPU와 CPU 사용률
CPU가 여러 개여도 디스크가 하나뿐이라면, CPU 부하는 다른 CPU로 분산되어도 I/O 부하는 분산되지 않는다.
- Load Average는 실행 큐에 있는 프로세스의 수를 센 값으로, 커널 내의 전역변수 배열에 저장된다. 시스템 전체에 대한 값 하나뿐이다.
- CPU 사용률은 각 CPU용으로 준비된 전용 영역에 저장된다. 그래서
sar등에서 CPU별 정보를 얻을 수 있다.
정리하면 Load Average는 시스템 전체 부하의 지표일 뿐 그 이상의 상세 분석은 불가능하다. CPU 사용률과 I/O 대기율은 CPU별로 개별 확인할 수 있고, 그렇게 확인할 필요가 있다.
CPU 부하가 높은 경우
- 사용자 프로그램의 처리가 병목인지, 시스템 프로그램이 원인인지
top,sar로 판단한다. ps로 프로세스 상태와 CPU 사용 시간을 보면서 원인 프로세스를 찾는다.- 더 상세히 조사할 때는
strace로 추적하거나oprofile로 프로파일링해서 병목 지점을 좁혀 간다.
I/O 부하가 높은 경우
프로그램의 입출력 자체가 많은 경우와, 스왑이 발생해 디스크 액세스가 일어나는 경우로 나뉜다. sar, vmstat으로 스왑 발생 상황을 확인해서 가려낸다.
- 프로그램 오류로 메모리를 지나치게 사용하고 있다면 프로그램을 개선한다.
- 탑재된 메모리가 부족하다면 메모리를 증설한다.
- 메모리 증설로 대응할 수 없다면 데이터 분산이나 캐시 서버 도입을 검토한다.
서버 종류에 따른 부하의 성격
- AP 서버는 DB에서 얻은 데이터를 가공해 클라이언트로 전달한다. 그 과정에서 대규모 I/O가 발생하는 일은 드물기 때문에 CPU 바운드한 서버이다.
- DB 서버는 디스크에서 데이터를 검색하는 것이 주된 작업이므로 I/O 바운드한 서버이다.
튜닝
튜닝의 본래 의미는 병목을 발견해 제거하는 작업이다. 하드웨어나 소프트웨어가 본래 지닌 성능 이상을 내는 것은 불가능하다. 본래 성능을 충분히 발휘할 수 있도록 문제가 되는 부분을 제거하는 것이다.
예를 들어 I/O 성능을 개선하려면 다음을 규명해야 한다.
- 메모리를 증설해서 캐시 영역을 확보하면 대응할 수 있는가?
- 원래 데이터량이 너무 많지는 않은가?
- 애플리케이션 측의 I/O 알고리즘을 변경할 필요가 있는가?
원인을 알면 대응 방법은 자명해진다. 그렇게 자명해진 대응 방법을 실천하는 것이 튜닝이다.