
Real MySQL 8.0 Ch.4 — InnoDB 스토리지 엔진 아키텍처
InnoDB의 MVCC와 데드락 감지, 버퍼 풀, 언두·리두 로그, 체인지 버퍼, 어댑티브 해시 인덱스를 정리한다.
시리즈 · Computer Science 서적2 / 8
- Real MySQL 8.0 Ch.4 — MySQL 엔진과 스레드 구조
- Real MySQL 8.0 Ch.4 — InnoDB 스토리지 엔진 아키텍처
- Real MySQL 8.0 Ch.5 — 트랜잭션과 잠금
- Real MySQL 8.0 Ch.6~7 — 데이터 압축과 암호화
- Real MySQL 8.0 Ch.8 — B-Tree 인덱스
- Real MySQL 8.0 Ch.8 — R-Tree, 전문 검색, 함수 기반, 멀티 밸류 인덱스
- Real MySQL 8.0 Ch.8 — 클러스터링 인덱스, 유니크 인덱스, 외래키
- Real MySQL 8.0 Ch.9 — 옵티마이저와 기본 데이터 처리
InnoDB는 MySQL 스토리지 엔진 중 거의 유일하게 레코드 기반 잠금을 제공한다. 그 덕분에 높은 동시성 처리가 가능하고 안정적이며 성능이 뛰어나다.
PK에 의한 클러스터링
- 테이블은 PK 값의 순서대로 디스크에 저장된다.
- 세컨더리 인덱스는 레코드의 물리 주소 대신 PK 값을 논리적인 주소로 사용한다.
- PK가 곧 클러스터링 인덱스이므로 PK를 이용한 레인지 스캔이 빠르다.
- 실행 계획에서도 PK는 다른 보조 인덱스보다 비중이 높게 설정된다.
클러스터링 인덱스의 장단점은 Ch.8 — 클러스터링 인덱스, 유니크 인덱스, 외래키에서 따로 다룬다.
MVCC
잠금을 사용하지 않는 일관된 읽기를 제공하는 기능으로, 언두 로그로 구현한다.
- UPDATE가 실행되면 원본을 언두 로그에 복사한 뒤 버퍼 풀의 데이터를 변경한다.
- 아직 커밋되지 않은 변경을 다른 트랜잭션이 조회하면, 격리 수준에 따라 어느 영역을 읽을지가 결정된다. READ COMMITTED 이상에서는 버퍼 풀의 변경된 내용이 아니라 언두 영역의 데이터를 읽는다.
같은 MVCC라도 PostgreSQL은 구현 방식이 다르다. PostgreSQL Vacuum 이해와 AutoVacuum 튜닝에 정리했다.
자동 데드락 감지
InnoDB는 잠금 대기 목록을 그래프(Wait-for List) 형태로 관리한다. 데드락 감지 스레드가 이 그래프를 주기적으로 검사해 교착 상태에 빠진 트랜잭션을 찾고, 그중 하나를 강제 종료한다.
- 종료 대상은 언두 로그 양으로 판단한다. 언두 로그 레코드를 더 적게 가진 트랜잭션이 롤백 대상이 된다. 롤백할 내용이 적어 부하가 덜하기 때문이다.
- InnoDB는 MySQL 엔진이 관리하는 테이블 잠금을 볼 수 없어 데드락 감지가 불확실할 수 있다.
innodb_table_locks를 활성화하면 테이블 레벨 잠금까지 감지한다. - 데드락 감지 스레드는 검사하는 동안 잠금 상태가 바뀌지 않도록 잠금 테이블에 새로운 잠금을 건다. 동시 처리 스레드가 많으면 작업 중이던 스레드들이 대기하게 되어 서비스에 악영향을 줄 수 있다.
innodb_deadlock_detect를 OFF로 설정하면 감지 스레드가 동작하지 않는다. 이때는innodb_lock_wait_timeout을 설정해, 일정 시간 잠금을 얻지 못한 요청이 자동으로 실패하게 해야 한다.
데드락 감지를 끈다면 innodb_lock_wait_timeout을 기본값 50초보다 훨씬 낮게 잡는 것이 좋다.
버퍼 풀
버퍼 풀은 디스크의 데이터 파일과 인덱스 정보를 메모리에 캐시해 두는 공간이다. 동시에 쓰기 작업을 지연시켜 일괄 처리하게 해 주는 버퍼 역할도 한다. 변경이 일어날 때마다 발생할 랜덤 디스크 작업을 모아서 처리하는 것이다.
크기 설정
innodb_buffer_pool_size로 설정하며, 5.7부터는 동적으로 조절할 수 있다.- 작은 값에서 시작해 조금씩 늘려 가는 방법이 좋다.
- 메모리가 8GB 미만이라면 50% 정도를 버퍼 풀로 설정한다.
- 버퍼 풀 외에 레코드 버퍼도 상당한 메모리를 쓸 수 있다. 세션이 레코드를 읽고 쓸 때 쓰는 공간이어서, 커넥션과 사용하는 테이블이 많으면 커진다.
구조
버퍼 풀은 메모리 공간을 페이지 크기의 조각으로 나누고, 필요한 데이터 페이지를 읽어 각 조각에 저장한다. 이 조각들을 세 가지 자료 구조로 관리한다.
- Free 리스트: 사용자 데이터로 채워지지 않은 빈 페이지 목록
- LRU 리스트: 읽어 온 페이지를 최대한 오래 메모리에 유지하기 위한 목록
- 플러시 리스트: 디스크로 동기화되지 않은 데이터를 가진 페이지(더티 페이지)를 변경 시점 기준으로 관리하는 목록
한 번이라도 변경된 페이지는 플러시 리스트에서 관리된다. 리두 로그가 디스크에 기록됐다고 해서 데이터 페이지까지 디스크에 기록됐다는 보장은 없다. 그래서 체크포인트를 발생시켜 리두 로그와 데이터 페이지의 상태를 동기화한다. 체크포인트는 장애 복구 시 리두 로그의 어느 부분부터 복구를 실행할지 판단하는 기준점이 된다.
변형된 LRU
일반적인 LRU는 Head에 가장 최신 페이지를 두고 Tail의 오래된 페이지를 제거한다. InnoDB는 리스트를 New와 Old 두 개의 서브리스트로 나누어 쓴다.
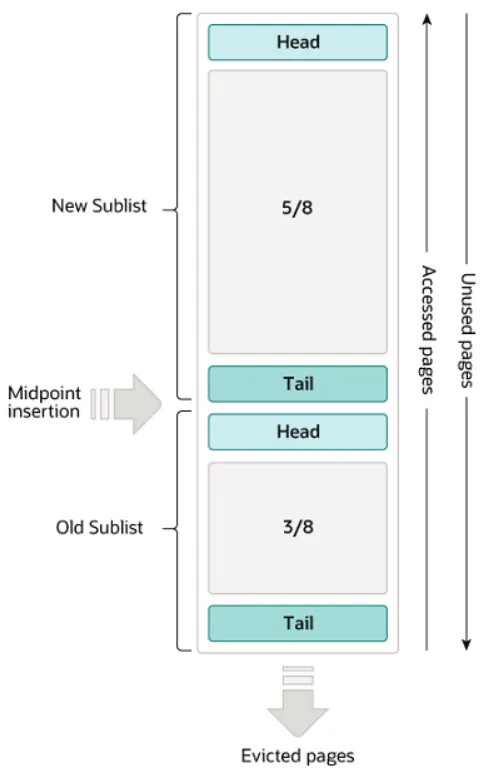
- New의 Tail과 Old의 Head가 만나는 지점이 Midpoint다.
- 새로 읽은 페이지는 Old의 Head에 들어간다.
- 다시 참조되면 New의 Head로 이동하고, 참조되지 않으면 Old의 Tail로 밀려나 빠르게 제거된다.
단순 LRU에서는 WHERE 절 없는 SELECT처럼 일회성으로 대량의 페이지를 읽을 때, 자주 쓰이던 페이지가 밀려날 수 있다. Midpoint 삽입은 이 문제를 막기 위한 구조다.
버퍼 풀과 리두 로그
버퍼 풀의 용도는 데이터 캐시와 쓰기 버퍼링 두 가지인데, 메모리를 늘리는 것만으로는 데이터 캐시 기능만 좋아진다. 쓰기 버퍼링까지 향상시키려면 리두 로그와의 관계를 알아야 한다.
- 버퍼 풀에는 변경되지 않은 클린 페이지와 변경된 더티 페이지가 함께 있다. 더티 페이지는 언젠가 디스크에 기록돼야 한다.
- 리두 로그는 고정 크기 파일을 연결해 순환 고리처럼 쓴다. 변경이 계속되면 기존 엔트리가 새 엔트리로 덮어 쓰인다.
- 그래서 재사용 가능한 공간과 당장 재사용할 수 없는 공간을 구분해야 한다. 후자가 활성 리두 로그(Active Redo Log)다.
- 로그 포지션은 기록될 때마다 계속 증가하는 값을 가지며, 이것이 LSN(Log Sequence Number)이다.
- InnoDB는 주기적으로 체크포인트 이벤트를 발생시켜 리두 로그와 더티 페이지를 디스크로 동기화한다. 가장 최근 체크포인트의 LSN이 활성 리두 로그의 시작점이다.
- 최근 체크포인트의 LSN과 마지막 리두 로그 엔트리의 LSN 차이가 Checkpoint Age이며, 곧 활성 리두 로그 공간의 크기다.
더티 페이지 비율이 너무 높은 상태에서 갑자기 버퍼 풀 공간이 필요해지면 매우 많은 더티 페이지를 한 번에 기록해야 한다. 버퍼 풀이 100GB 이하인 서버라면 리두 로그 파일 전체 크기를 5~10GB 정도로 잡고, 필요할 때마다 조금씩 늘려 가며 최적값을 찾는 것이 좋다.
버퍼 풀 상태 백업 및 복구
서버를 재시작한 직후처럼 데이터가 버퍼 풀에 적재되지 않은 상태에서는 쿼리 속도가 몇십 배까지 느려질 수 있다.
- 5.5에서는 강제 워밍업을 위해 주요 테이블과 인덱스를 풀 스캔한 뒤 서비스를 오픈했다.
- 5.6부터 버퍼 풀 덤프 및 적재 기능이 도입됐다.
- 수동:
innodb_buffer_pool_dump_now로 백업하고innodb_buffer_pool_load_now로 복구한다. - 자동:
innodb_buffer_pool_dump_at_shutdown,innodb_buffer_pool_load_at_startup을 설정한다.
Double Write Buffer
더티 페이지를 디스크로 플러시하다가 하드웨어 오작동이나 시스템 비정상 종료로 페이지의 일부만 기록되면 복구할 수 없게 될 수 있다. 이런 페이지를 파셜 페이지(Partial-page) 또는 톤 페이지(Torn-page)라고 한다.
이를 막기 위해 InnoDB는 더티 페이지를 데이터 파일에 쓰기 전에, 먼저 묶어서 시스템 테이블스페이스의 Double Write Buffer에 한 번 기록한다. 그다음 각 페이지를 데이터 파일의 제 위치에 랜덤 쓰기로 기록한다. 데이터 파일 쓰기 도중 문제가 생기면 Double Write Buffer의 내용으로 복구한다.
언두 로그
InnoDB는 트랜잭션과 격리 수준을 보장하기 위해, DML로 변경되기 이전 버전의 데이터를 별도로 백업한다. 이 백업 데이터가 언두 로그다.
- 트랜잭션 보장: 롤백하면 언두 로그에 백업해 둔 이전 버전으로 복구한다.
- 격리 수준 보장: 변경 중인 레코드를 다른 커넥션이 조회하면, 격리 수준에 맞게 언두 로그의 데이터를 읽어서 반환하기도 한다.
UPDATE member SET name = '홍길동' WHERE member_id = 1;이 문장을 실행하면 커밋하지 않아도 버퍼 풀의 데이터는 새 값으로 바뀌고, 변경 전 값은 언두 로그에 복사된다. 커밋하면 현재 상태가 그대로 유지되고, 롤백하면 언두 영역의 데이터로 되돌린다.
언두 로그가 커지는 이유
- 트랜잭션이 완료돼도 언두 로그를 바로 삭제할 수 없다. 그보다 먼저 시작한 트랜잭션이 아직 끝나지 않았을 수 있기 때문이다.
- 어떤 트랜잭션이 하루 동안 열려 있으면, 그 하루 동안의 변경 이전 데이터가 모두 언두 로그에 쌓인다.
- DELETE도 삭제 이전 데이터를 언두 로그에 저장한다.
- 5.5까지는 한 번 늘어난 언두 로그 공간을 서버를 새로 구축하지 않는 한 줄일 수 없었다. 5.7과 8.0에서 해결됐다.
그래서 언두 로그가 급증하지 않는지 모니터링해야 한다.
언두 테이블스페이스
언두 로그가 저장되는 공간이다. 예전에는 시스템 테이블스페이스에 저장했고 innodb_undo_tablespaces로 별도 파일을 쓰도록 설정할 수 있었다. 8.0부터는 항상 시스템 테이블스페이스 외부의 별도 파일에 기록되며, 언두 테이블스페이스를 동적으로 추가하고 삭제할 수 있다.
체인지 버퍼
레코드가 변경되면 데이터 파일뿐 아니라 그 테이블의 인덱스도 갱신해야 한다. 인덱스 갱신은 디스크를 랜덤하게 읽어야 해서 자원 소모가 크다.
- 변경할 인덱스 페이지가 버퍼 풀에 있으면 바로 갱신한다.
- 버퍼 풀에 없으면 임시 공간에 저장해 두고 사용자에게 결과를 먼저 반환한다. 이 임시 메모리 공간이 체인지 버퍼(Change Buffer)다.
- 임시로 저장된 인덱스 레코드는 백그라운드의 체인지 버퍼 머지 스레드가 나중에 병합한다.
- 중복 여부를 반드시 확인해야 하는 유니크 인덱스는 체인지 버퍼를 사용할 수 없다.
리두 로그와 로그 버퍼
리두 로그는 ACID 중 D(Durability)와 관련이 있다. 서버가 비정상 종료됐을 때 데이터 파일에 기록되지 못한 데이터를 잃지 않게 해 주는 안전장치다.
데이터 파일 쓰기는 디스크 랜덤 액세스가 필요해 비용이 크다. 그래서 변경 내용을 쓰기 비용이 낮은 로그 구조에 먼저 기록해 두고, 장애가 나면 이 로그로 복구한다.
비정상 종료 후 데이터 파일은 두 종류의 일관되지 않은 데이터를 가질 수 있다.
- 커밋됐지만 데이터 파일에 기록되지 않은 데이터: 리두 로그의 내용을 데이터 파일에 다시 복사한다.
- 롤백됐지만 데이터 파일에 이미 기록된 데이터: 언두 로그의 내용으로 되돌린다. 이때 변경이 커밋됐는지 롤백됐는지 알기 위해 리두 로그도 필요하다.
디스크 동기화 주기
리두 로그는 트랜잭션이 커밋되면 즉시 디스크에 기록되도록 설정하는 것을 권장한다. 다만 커밋마다 디스크 동기화가 일어나면 부하가 크므로, innodb_flush_log_at_trx_commit으로 동기화 주기를 정할 수 있다.
| 값 | 동작 |
|---|---|
| 0 | 1초에 한 번 디스크에 기록하고 동기화한다. 서버가 비정상 종료되면 최대 1초의 트랜잭션을 잃을 수 있다. |
| 1 | 커밋할 때마다 디스크에 기록하고 동기화한다(기본값). |
| 2 | 커밋할 때마다 OS 버퍼까지 기록하고, 디스크 동기화는 1초에 한 번 한다. |
로그 버퍼와 리두 로그 파일 크기
- 변경이 많은 서버에서는 리두 로그 기록 작업이 성능에 큰 영향을 준다. 그래서 ACID를 보장하는 수준에서 버퍼링하는데, 이때 쓰는 공간이 로그 버퍼다. 기본 크기는 16MB다.
- 리두 로그 파일의 전체 크기는 버퍼 풀의 크기에 맞게 정해야 한다. 그래야 변경된 내용을 버퍼 풀에 모았다가 한 번에 디스크에 기록할 수 있다.
리두 로그 비활성화
데이터를 복구하거나 대용량 데이터를 한 번에 적재할 때는 리두 로그를 비활성화해 적재 시간을 줄일 수 있다.
ALTER INSTANCE DISABLE INNODB REDO_LOG;
-- 데이터 적재 후 반드시 다시 활성화한다.
ALTER INSTANCE ENABLE INNODB REDO_LOG;
어댑티브 해시 인덱스
사용자가 자주 요청하는 데이터에 대해 InnoDB가 자동으로 생성하는 인덱스다. B-Tree 검색 시간을 줄이기 위해 도입됐다.
- 자주 읽히는 데이터 페이지의 키 값으로 해시 인덱스를 만들어 두고, 검색할 때 이 해시 인덱스로 레코드가 저장된 데이터 페이지를 즉시 찾아간다.
- B-Tree를 루트 노드부터 리프 노드까지 찾아가는 비용이 없어진다.
- 버퍼 풀에 올라온 데이터 페이지에 대해서만 관리된다.
구조
- 인덱스 키 값과 데이터 페이지 주소의 쌍으로 관리한다.
- 인덱스 키 값은 B-Tree 인덱스의 고유 번호(ID)와 B-Tree 인덱스의 실제 키 값을 조합한 것이다. 어댑티브 해시 인덱스가 서버 안에 하나만 존재하기 때문이다.
- 하나의 메모리 객체여서 내부 잠금 경합이 심했다. 8.0부터는 파티션 기능을 제공하며,
innodb_adaptive_hash_index_parts로 파티션 개수를 설정한다(기본값 8).
도움이 되는 경우와 아닌 경우
| 도움이 되는 경우 | 도움이 되지 않는 경우 |
|---|---|
| 디스크의 데이터가 버퍼 풀 크기와 비슷해 디스크 읽기가 많지 않은 경우 | 디스크 읽기가 많은 경우 |
동등 조건 검색(=, IN)이 많은 경우 |
조인이나 LIKE 패턴 검색 같은 특정 패턴의 쿼리가 많은 경우 |
| 쿼리가 데이터 중 일부에만 집중되는 경우 | 매우 큰 테이블의 레코드를 폭넓게 읽는 경우 |
어댑티브 해시 인덱스는 메모리 안에서 데이터 페이지에 접근하는 것을 더 빠르게 만드는 기능이다. 디스크에서 읽어 오는 경우가 빈번하면 아무런 도움이 되지 않는다.
성능 확인
- 히트율이 28% 정도라도 CPU 사용량이 100%에 근접한 서버라면 효율적으로 쓰이고 있는 것이다.
- CPU 사용량이 높지 않은데 히트율이 28% 정도라면 비활성화하는 편이 나을 수 있다.
- 어댑티브 해시 인덱스의 메모리 사용량이 높다면, 비활성화하고 그만큼 버퍼 풀에 메모리를 더 주는 것도 좋은 방법이다.
정리
MEMORY, MyISAM과 비교하면 동시 처리 성능은 InnoDB가 가장 좋다. 레코드 수준의 잠금을 제공하기 때문이다. 이 잠금은 Ch.5 — 트랜잭션과 잠금에서 이어서 다룬다.
참고
- Real MySQL 8.0