
SQL 레벨업 Ch.1 — DBMS 아키텍처
버퍼와 로그, 워킹 메모리, 옵티마이저가 실행 계획을 고르는 과정까지 DBMS 내부 구조를 정리했다.
시리즈 · BackEnd 서적1 / 17
- SQL 레벨업 Ch.1 — DBMS 아키텍처
- SQL 레벨업 Ch.3 — SQL의 조건 분기
- SQL 레벨업 Ch.4~5 — 집약과 자르기, 반복문
- SQL 레벨업 Ch.6 — 결합
- SQL 레벨업 Ch.7 — 서브쿼리
- SQL 레벨업 Ch.8 — SQL의 순서
- SQL 레벨업 Ch.9 — 갱신과 데이터 모델
- SQL 레벨업 Ch.10 — 인덱스 사용
- 오브젝트 Ch.1 — 객체, 설계
- 오브젝트 Ch.2 — 객체지향 프로그래밍
- 오브젝트 Ch.3~4 — 역할, 책임, 협력 / 설계 품질과 트레이드오프
- 오브젝트 Ch.5 — 책임 할당하기
- 오브젝트 Ch.6 — 메시지와 인터페이스
- 오브젝트 Ch.8 — 의존성 관리하기
- 오브젝트 Ch.9 — 유연한 설계
- 오브젝트 Ch.10, 12 — 상속과 코드 재사용, 다형성
- 오브젝트 Ch.13 — 서브클래싱과 서브타이핑
DBMS 아키텍처 개요
- 쿼리 평가 엔진: 입력받은 SQL을 분석하고 어떤 순서로 데이터에 접근할지 결정한다. 이때 결정되는 계획이 실행 계획이고, 실행 계획에 따라 데이터에 접근하는 방법을 접근 메서드(access method)라고 부른다. 계획을 세우고 실행하는 DBMS의 핵심 모듈이다.
- 버퍼 매니저: DBMS가 특별한 용도로 확보해 둔 메모리 영역(버퍼)을 관리한다. 디스크 용량 매니저와 연동되어 동작한다.
- 디스크 용량 매니저: 데이터를 어디에 어떻게 저장할지 관리하고 읽기/쓰기를 제어한다.
- 트랜잭션 매니저 · 락 매니저: 트랜잭션과 락을 관리한다.
- 리커버리 매니저: 데이터를 정기적으로 백업하고 장애 시 복구한다.
DBMS와 버퍼
메모리는 한정된 자원이고 데이터는 훨씬 많다. 그래서 자주 참조되는 데이터만 메모리에 올려 성능을 높이는데, 이 메모리를 버퍼(buffer) 또는 캐시(cache)라고 부른다. 무엇을 얼마 동안 올려 둘지에서 트레이드오프가 생기고, 이를 관리하는 것이 버퍼 매니저다.
데이터 캐시와 로그 버퍼
- 데이터 캐시: 디스크에 있는 데이터의 일부를 메모리에 유지하는 영역
- 로그 버퍼: INSERT, DELETE, UPDATE, MERGE 같은 갱신 요청을 받는 영역. 저장소의 데이터를 곧바로 바꾸지 않고 변경 정보를 로그 버퍼에 쌓아 둔 뒤 나중에 디스크에 반영한다.
즉 갱신은 SQL 실행 시점과 저장소 반영 시점이 다른 비동기 처리다. 저장소 갱신에는 시간이 오래 걸리므로, 갱신 정보를 받은 시점에 로그만 쌓고 실제 처리는 내부적으로 수행한다.
동기와 비동기의 트레이드오프
메모리는 휘발성이라 DBMS가 다운되면 로그 버퍼의 내용이 사라질 수 있다. 이를 막기 위해 커밋 시점에는 갱신 정보를 반드시 영속적인 저장소에 쓴다. 커밋만큼은 동기로 처리해 장애가 나도 정합성을 유지하는 것이다.
- 비동기 처리: 정합성 ↓, 성능 ↑
- 동기 처리: 정합성 ↑, 성능 ↓
두 버퍼의 크기
DBMS의 기본 설정은 데이터 캐시에 비해 로그 버퍼가 매우 작다. 데이터베이스가 기본적으로 검색 위주로 쓰인다고 가정하기 때문이다. 검색은 수천만 건을 다루기도 하지만 갱신은 많아야 수만 건 수준이므로, 비싼 메모리를 갱신보다 자주 검색하는 데이터의 캐시에 쓰는 편이 유리하다.
다만 시스템 특성에 따라 조정해야 한다. 갱신이 검색보다 많은 시스템이라면 로그 버퍼를 키우는 쪽을 고려한다.
워킹 메모리
두 버퍼 외에 정렬·해시 처리에 쓰는 작업용 영역이 워킹 메모리다. ORDER BY, 집합 연산, 윈도우 함수 등을 실행할 때 사용된다.
워킹 메모리가 부족하면 저장소를 대신 사용하기 때문에 속도가 크게 떨어진다.
- Oracle: 임시 테이블스페이스(TEMP Tablespace)
- MSSQL: TEMPDB
- PostgreSQL: 일시 영역(pgsql_tmp)
DBMS와 실행 계획
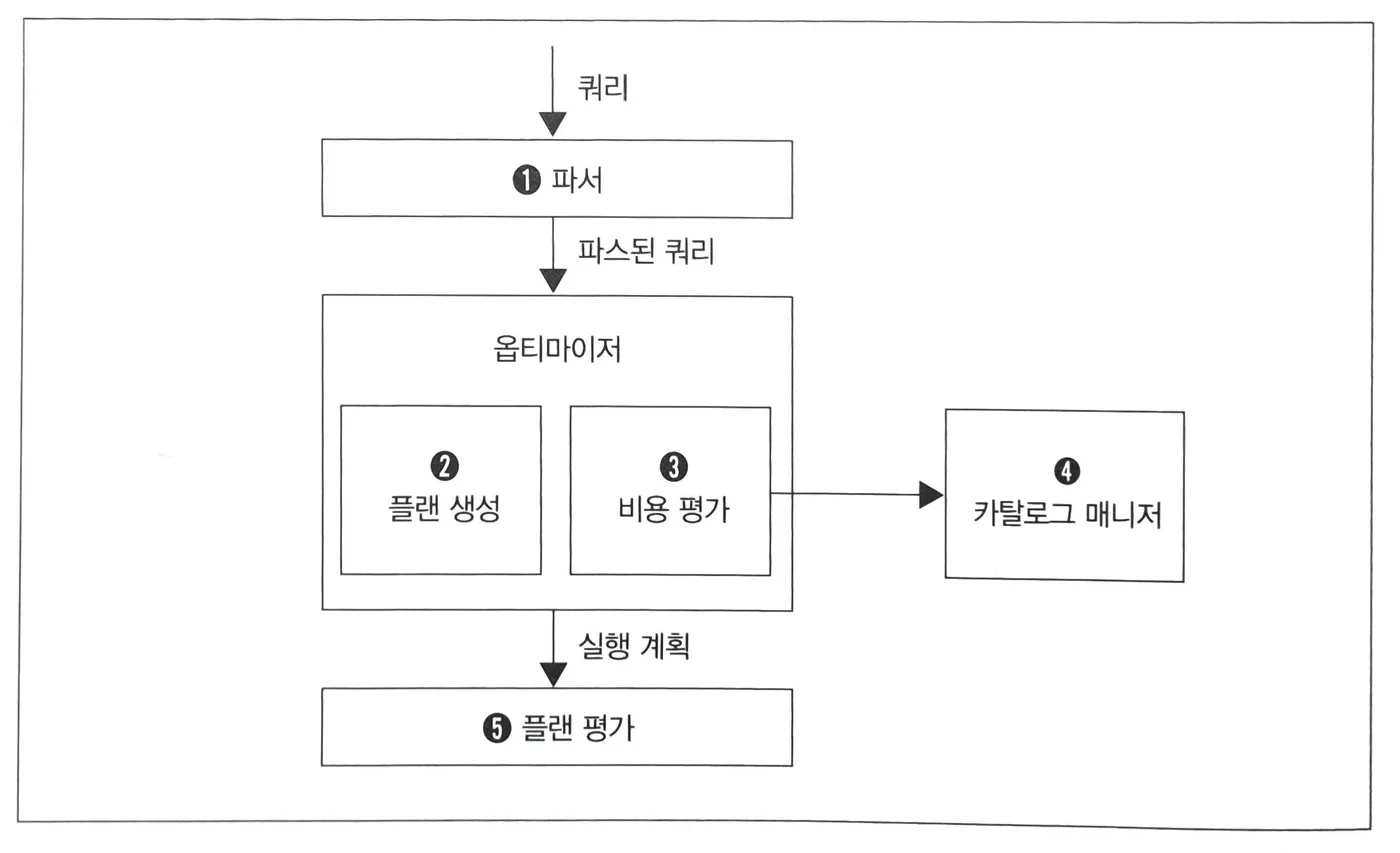
- 파서(parser): SQL 구문이 올바른지 검사한다.
- 옵티마이저(optimizer): 인덱스 유무, 데이터 분산과 편향, 매개변수 등을 고려해 가능한 실행 계획을 여러 개 만들고 각각의 비용을 계산한다.
- 카탈로그 매니저(catalog manager): 테이블과 인덱스의 통계 정보를 제공해 옵티마이저의 비용 계산을 돕는다.
- 플랜 평가(plan evaluation): 후보 실행 계획 중 최적의 것을 선택한다.
옵티마이저에게 맡긴다고 항상 최적의 플랜이 선택되지는 않는다. 대표적인 원인은 통계 정보 부족이다. 데이터가 크게 바뀌었는데 카탈로그의 통계가 갱신되지 않으면 과거 정보를 기준으로 계획을 고르게 된다. 테이블 데이터가 많이 바뀌면 통계 정보도 갱신해야 하지만, 갱신 자체의 실행 비용도 크다.
실행 계획 읽기
- 테이블 풀 스캔(Full Scan): O(n)
- 인덱스 스캔: O(log n)
결합에 쓰이는 알고리즘은 세 가지다.
- Nested Loops: 한쪽 테이블을 읽으며 레코드 하나마다 결합 조건에 맞는 레코드를 다른 테이블에서 찾는다. 이중 for문과 같다.
- Sort Merge: 결합 키로 양쪽을 정렬한 뒤 순차적으로 결합한다. 정렬을 위해 워킹 메모리를 사용한다.
- Hash: 결합 키로 해시 테이블을 만든다. 역시 작업용 메모리가 필요하다.
실행 계획은 일반적으로 트리 구조이며 중첩 단계가 깊을수록 먼저 실행된다. 옵티마이저가 완벽하지 않으므로 힌트 구를 사용해 실행 계획을 수동으로 조정할 수도 있다.