
JOIN의 종류와 구현 방식
INNER·OUTER JOIN의 차이와 Nested Loop, Sort-Merge, Hash Join의 동작 방식, 인덱스의 영향을 정리한다.
시리즈 · Database4 / 8
JOIN의 종류
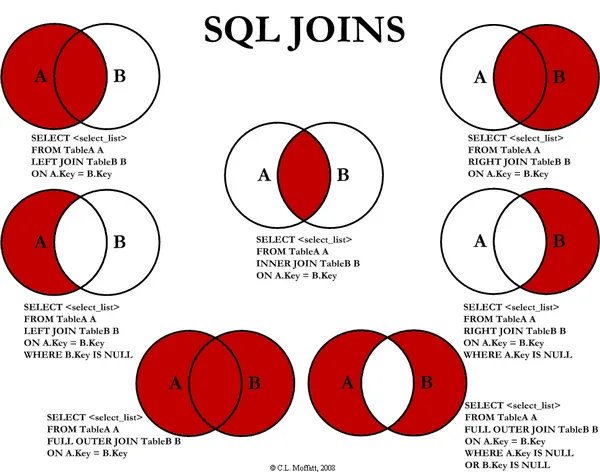
- INNER JOIN: 조인 조건을 만족하는 행만 반환한다(교집합).
- LEFT / RIGHT OUTER JOIN: 한쪽 테이블의 모든 행을 반환하고, 반대쪽은 조건이 맞는 행만 붙인다. 맞는 행이 없으면 NULL로 채운다.
- FULL OUTER JOIN: 양쪽 테이블의 모든 행을 반환한다(합집합).
Oracle은 FULL OUTER JOIN을 지원하지만 MySQL은 지원하지 않는다. MySQL에서는 LEFT JOIN과 RIGHT JOIN의 결과를 UNION으로 합쳐서 같은 결과를 만든다.
JOIN 구현 방식
Nested Loop Join
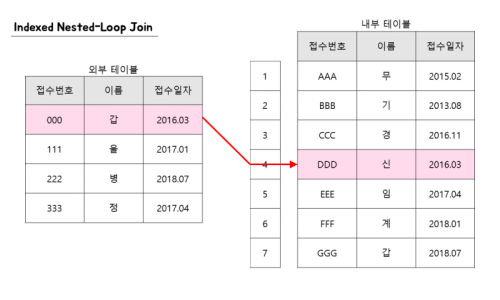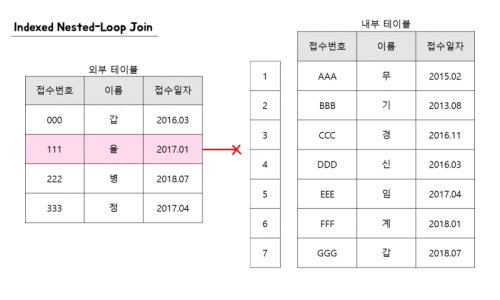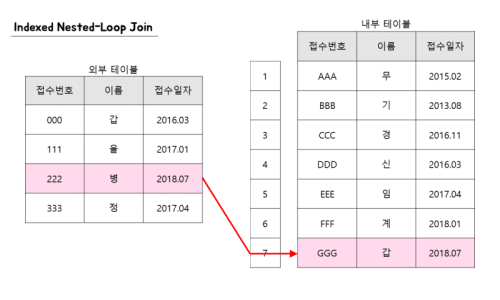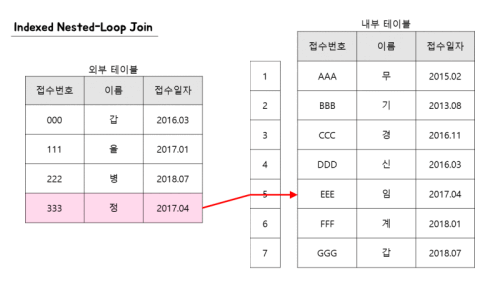
바깥 테이블(Driving Table)의 행을 하나씩 읽으면서, 그때마다 안쪽 테이블에서 조건에 맞는 행을 찾는 방식이다.
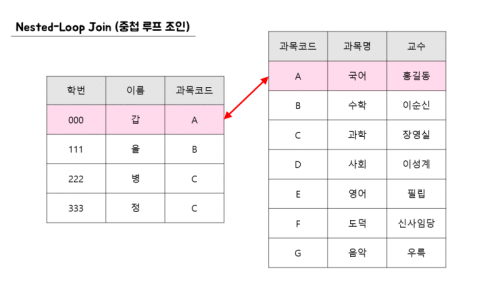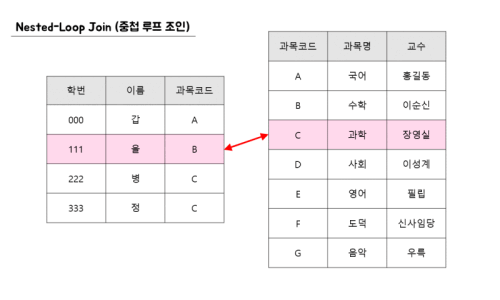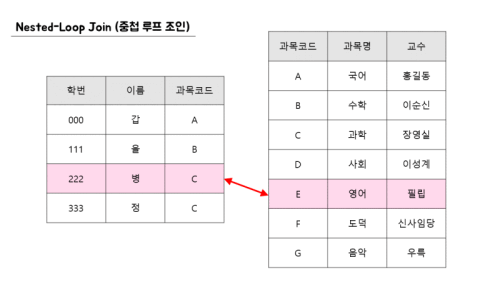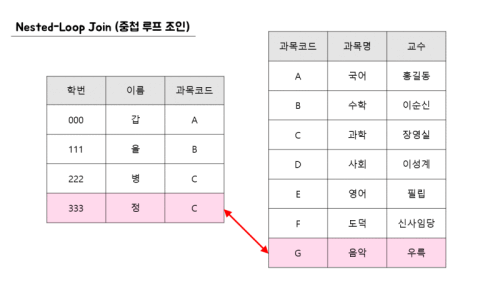
- 모든 조인 조건에 적용할 수 있다.
- 행을 일일이 비교하므로, 조건을 만족하는 행이 많을수록 반복 접근이 늘어 느려진다.
- 어느 테이블을 먼저 읽느냐에 따라 속도 차이가 크게 난다. Driving Table의 선택이 매우 중요하다.
Sort-Merge Join
두 테이블을 각각 조인 키로 정렬한 뒤, 차례로 스캔하면서 병합한다. 주로 동등 조인에 사용한다.
Hash Join
한쪽 테이블의 조인 키로 해시 테이블을 만들고, 다른 쪽 테이블을 읽으면서 해시 테이블을 탐색한다.
- 동등 조인에만 사용할 수 있다.
- 해시 테이블을 만드는 비용이 들지만, 대량의 데이터를 조인할 때는 Nested Loop나 Sort-Merge보다 성능이 좋다.
내 쿼리가 어떤 방식으로 조인되는지 확인하기
실행 계획을 보면 된다.
- EXPLAIN: 쿼리를 실제로 실행하지 않고 실행 계획만 보여 주므로 DB에 부하를 주지 않는다.
- Auto Trace(Oracle): 쿼리를 실제로 실행한 결과를 함께 보여 준다.
인덱스가 JOIN 성능에 미치는 영향
인덱스가 없으면 조인 조건에 맞는 행을 찾기 위해 테이블의 모든 레코드를 스캔해야 한다. 조인 컬럼에 적절한 인덱스가 있으면 인덱스로 조건을 검색해 필요한 레코드만 가져올 수 있다.
결국 JOIN 성능을 개선하려면 조인 컬럼에 맞는 인덱스를 설계하는 것이 가장 중요하다.