
DB 클러스터링, 레플리케이션, 샤딩과 분산 트랜잭션
클러스터링과 레플리케이션의 차이, 2PC와 Saga, 복제 지연 대응(Semi-Sync, MHA), 샤딩 방식을 한 번에 정리한다.
시리즈 · Database7 / 8
클러스터링과 레플리케이션
클러스터링
- 여러 개의 DB를 수평적인 구조로 확장한다(Active - Standby).
- 노드 간 데이터를 동기화해 일관성 있는 데이터를 유지한다.
- 노드 1개가 죽어도 다른 노드로 운영할 수 있다.
- 장애가 전파된 경우에는 처리가 까다롭다.
레플리케이션
- 여러 개의 DB를 Master - Slave의 계층 구조로 확장한다.
- 동기화를 비동기로 수행한다.
분산 환경에서의 트랜잭션 관리
Two Phase Commit
두 단계를 거쳐 커밋이나 롤백을 진행하며, 트랜잭션을 조율하는 coordinator(조정자)가 존재한다.
- Prepare: 각 DB가 데이터를 저장할 수 있는 상태인지 확인한다.
- Commit: 모두 가능하면 커밋한다. 한 대라도 커밋할 수 없다면 모두 롤백한다.
단점은 다음과 같다.
- 지원하지 않는 NoSQL이 많다.
- 참여하는 서비스가 많아질수록 응답 시간이 지연된다.
- coordinator가 단일 장애 지점이 된다.
Saga 패턴
트랜잭션 관리 주체를 DBMS가 아닌 애플리케이션으로 옮기는 방식이다.
- 각 애플리케이션 하위의 DB는 로컬 트랜잭션만 관리한다.
- 연속된 트랜잭션의 실패 처리를 애플리케이션에서 구현해야 한다.
- 격리성은 보장하지 않지만 최종 일관성을 보장한다.
구현 방식은 두 가지다.
- Choreography-Based Saga: 각 애플리케이션이 로컬 트랜잭션을 처리한 뒤 완료 이벤트를 발행하고, 다음 애플리케이션이 그 이벤트를 수신해 다음 작업을 실행한다. 구축하기 쉽지만 트랜잭션의 현재 상태를 알기 어렵다.
- Orchestration-Based Saga: 트랜잭션 처리를 위한 별도의 Saga 인스턴스(매니저)가 존재한다. 각 작업의 완료·실패 여부를 매니저가 수신하고, 모두 완료되면 인스턴스를 종료한다.
복제 지연과 데이터 정합성
Master는 다중 스레드로 쓰기를 수행하고 Slave는 단일 스레드로 쓰기를 수행한다. 이 속도 차이 때문에 병목이 생기는데, 이를 복제 지연이라고 한다. 동기화가 끝나기 전까지 정합성을 지키는 방법을 살펴본다.
반동기 복제(Semi-Sync Replication)
- MySQL 5.5부터 도입됐다.
- 최소 1대 이상의 Slave에 복제에 필요한 릴레이 로그가 전달됐음을 보장한다.
- AFTER_SYNC 모드에서는 Master가 스토리지 엔진에 커밋하기 전에 Slave의 릴레이 로그 저장을 기다린다.
- 모든 Slave를 기다리지 않는다. 단 1대라도 릴레이 로그를 수신하면 Master는 트랜잭션을 완료한다.
최소한의 정합성을 확보하면서도, 특정 Slave의 지연이 트랜잭션 지연으로 이어지지 않는다.
MHA(Master High Availability)
Master DB의 고가용성을 위한 오픈소스다. Master에 장애가 발생하면 가장 최신 상태의 Slave를 자동으로 Master로 승격시켜 Fail-over한다.
Semi-Sync Replication과 함께 쓰면, 최소 한 대는 릴레이 로그를 수신한 상태이고 릴레이 로그 복구 과정을 통해 동기화하므로 데이터 유실 가능성을 낮출 수 있다.
샤딩
테이블의 데이터를 특정 기준으로 나누어 여러 DB에 저장하는 방식이다. 데이터를 고르게 분산해 저장해야 하고, 읽을 때 정확한 위치를 찾아야 한다. 이때 기준이 되는 것이 Shard Key다.
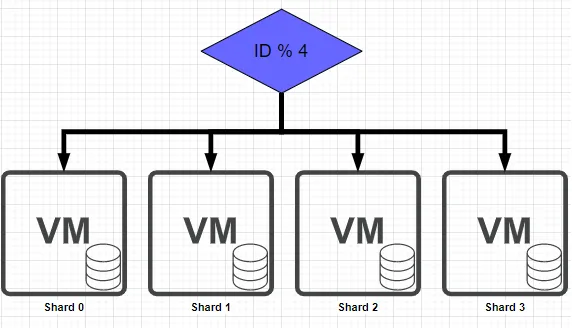
Hash Sharding
Shard Key에 해시 함수를 적용해 저장할 샤드를 정한다. 구현이 매우 간단하지만, DB가 추가되면 해시 함수가 바뀌어야 하므로 확장성이 낮다.
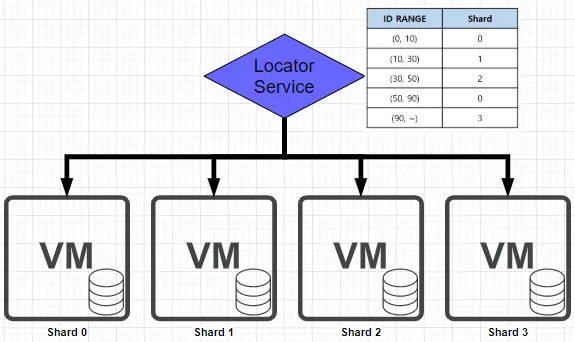
Dynamic Sharding
Locator Service가 Shard Key의 범위와 샤드의 매핑 테이블을 관리한다. 샤드가 추가되어도 매핑에 키만 추가하면 된다. 대신 Locator Service가 단일 장애 지점이어서, 장애가 나면 모든 샤드에 접근할 수 없게 된다.
파티셔닝과의 차이
- 샤딩: 데이터를 쪼개 여러 서버에 나누어 저장한다.
- 파티셔닝: 데이터를 나누되 모두 동일한 서버에 저장한다.
상황에 따른 선택
- 레플리케이션: 가용성과 내결함성이 중요할 때 선택한다. 읽기 작업을 분산하고 장애 복구를 쉽게 한다. 내결함성은 시스템 일부에 장애가 나도 계속 서비스할 수 있는 성질이다.
- 샤딩: 대량의 데이터 처리와 확장성이 중요할 때 선택한다. 쓰기 작업의 처리량을 높인다.