
메모리 계층 구조와 캐시 메모리
메모리 계층 구조와 L1·L2 캐시, 캐시 매핑 방식, 지역성과 배열 탐색 성능, 애플리케이션 캐시의 일관성 문제를 정리한다.
시리즈 · 운영체제13 / 18
- 운영체제의 유형
- System Call과 Dual Mode
- 인터럽트와 폴링
- 프로세스와 PCB, 프로세스의 상태 변화
- 프로세스 주소 공간과 Stack이 높은 주소부터 할당되는 이유
- 스레드: 사용자·커널 수준 스레드와 Thread Pool, Fork-Join
- Context Switching
- 프로세스 스케줄링: 단계와 알고리즘
- Thread Scheduling: 경합 범위 PCS와 SCS
- 경쟁 상태와 상호 배제: Thread Safe, 데커·피터슨 알고리즘
- 뮤텍스와 세마포, 모니터
- 교착 상태: 발생 조건과 해결 방법
- 메모리 계층 구조와 캐시 메모리
- 메모리 관리: 주소 바인딩과 연속 메모리 할당
- 가상 메모리: Paging과 Segmentation, TLB
- 요구 페이징과 페이지 교체 알고리즘, Thrashing
- File Descriptor와 File System, I-Node
- 동기/비동기와 블로킹/논블로킹, I/O Multiplexing
메모리 계층 구조
메모리는 프로세서가 연산할 데이터를 저장하는 공간이다. 속도와 용량, 비용이 서로 다른 여러 종류로 나누어 계층을 이룬다.
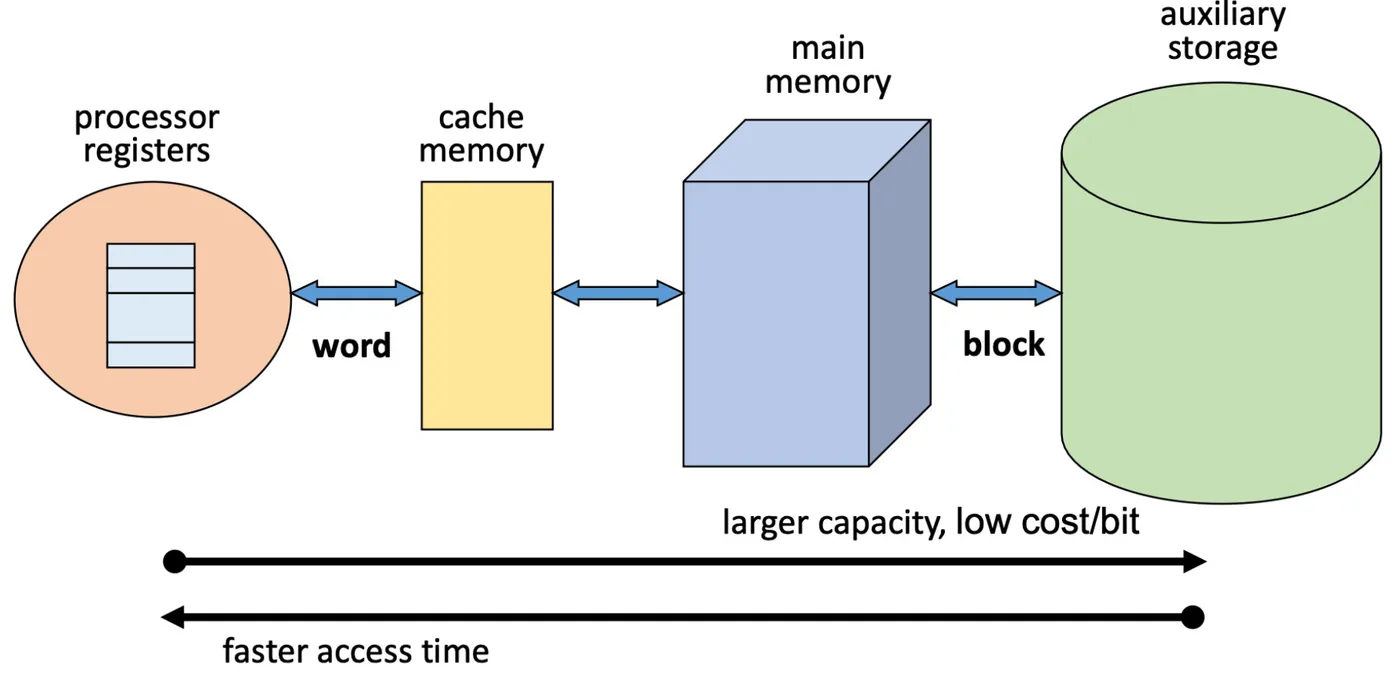
- 레지스터와 캐시는 CPU 내부에, 메인 메모리와 하드 디스크는 CPU 외부에 있다.
- CPU에 가까울수록 빠르고, 멀수록 용량이 크고 비트당 가격이 싸다.
- 하드 디스크의 데이터를 쓰려면 먼저 메모리로 옮긴 뒤 메모리에서 접근해야 한다.
계층 사이의 데이터 전송 단위는 다음과 같다.
- Block: 보조기억장치와 주기억장치 사이의 데이터 전송 단위 (1~4KB)
- Word: 주기억장치와 레지스터 사이의 데이터 전송 단위 (16~64bit)
캐시 메모리
캐시 메모리는 속도가 빠른 장치와 느린 장치 사이의 속도 차이로 생기는 병목 현상을 줄이기 위한 메모리다. CPU가 주기억장치에서 읽어 온 데이터 중 자주 사용하는 것을 캐시에 저장해 두고, 다음에 필요할 때 주기억장치가 아닌 캐시에서 먼저 찾아 속도를 높인다.
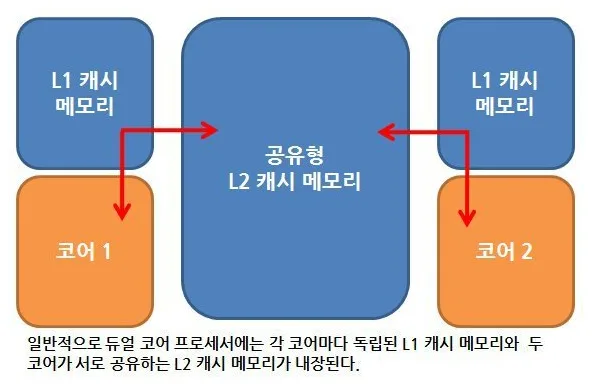
L1, L2 캐시
속도와 크기에 따라 Level을 나눈 것이다.
- L1 캐시: CPU 코어에 내장되어 가장 먼저 참조된다. 용량은 수십 KB 수준으로 가장 작지만 가장 빠르다. 데이터를 저장하는 L1 데이터 캐시와 명령어를 저장하는 L1 명령 캐시로 나뉜다.
- L2 캐시: L1에서 데이터를 찾지 못하면 참조한다. L1보다 크고 느리며, 용량은 수백 KB에서 수 MB 수준이다.
캐시 매핑 방식
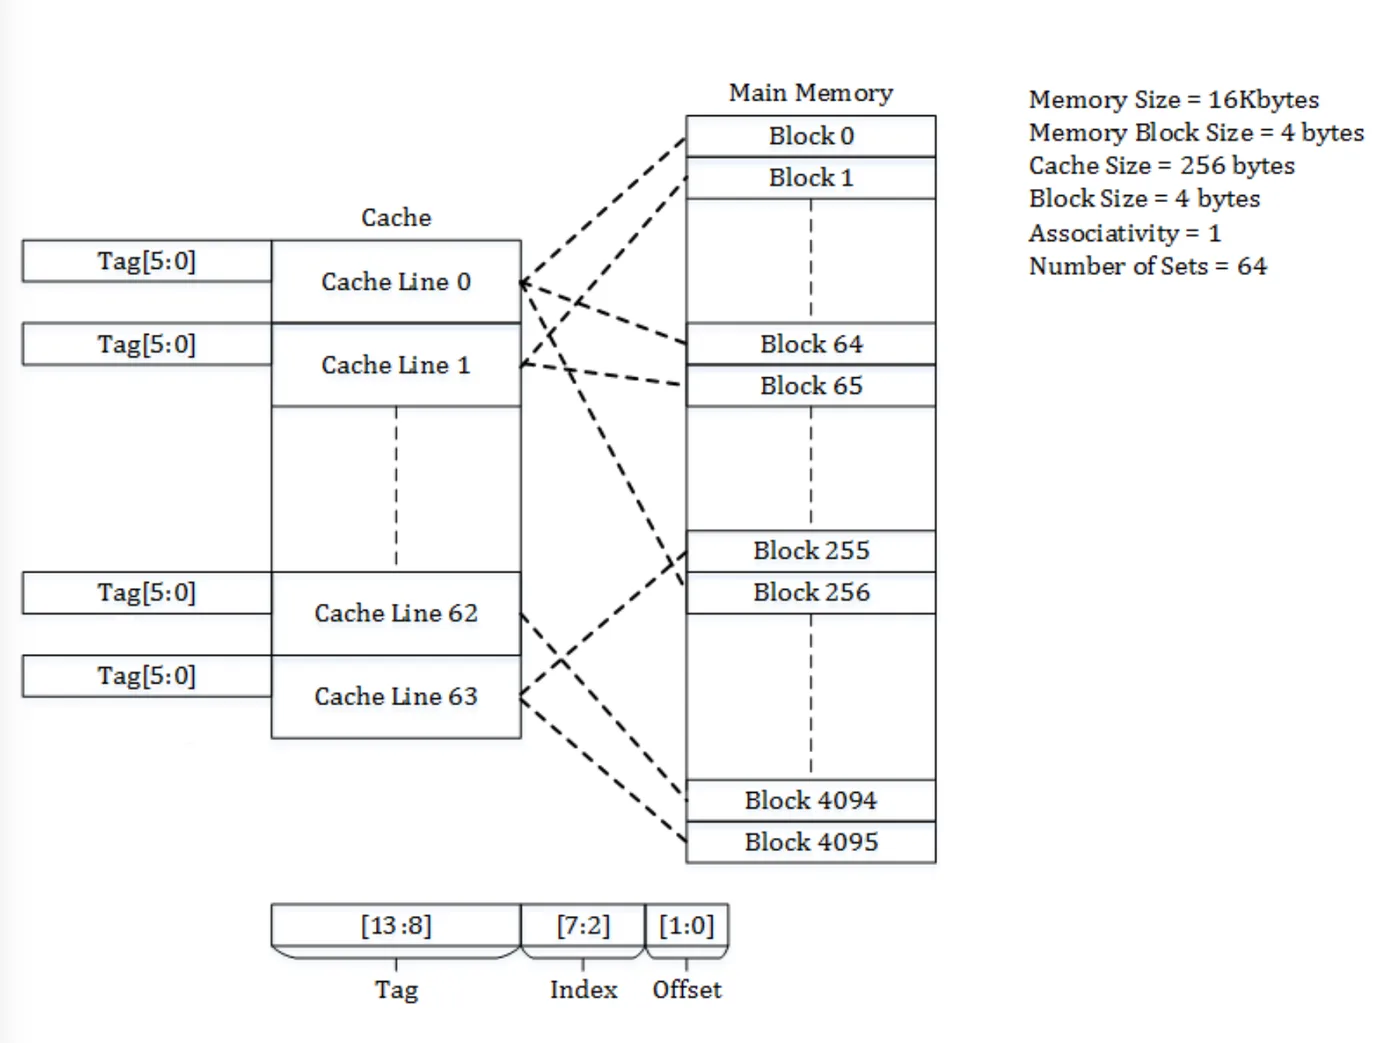
Direct Mapped Cache
- 하나의 세트가 하나의 캐시 라인(캐시 엔트리)만 가진다.
- 주기억장치를 캐시 크기로 나누어 순서대로 매핑한다. 캐시 라인이 4개라면 블록 0은 라인 0, 블록 1은 라인 1, 블록 2는 라인 2, 블록 3은 라인 3, 블록 4는 다시 라인 0에 대응한다.
- 유효 비트가 1이고 주소의 태그와 캐시의 태그가 일치하면 Cache Hit다.
- 문제점: 같은 라인에 대응하는 블록들이 번갈아 참조되면 서로를 계속 밀어내는 Conflict miss가 발생한다.
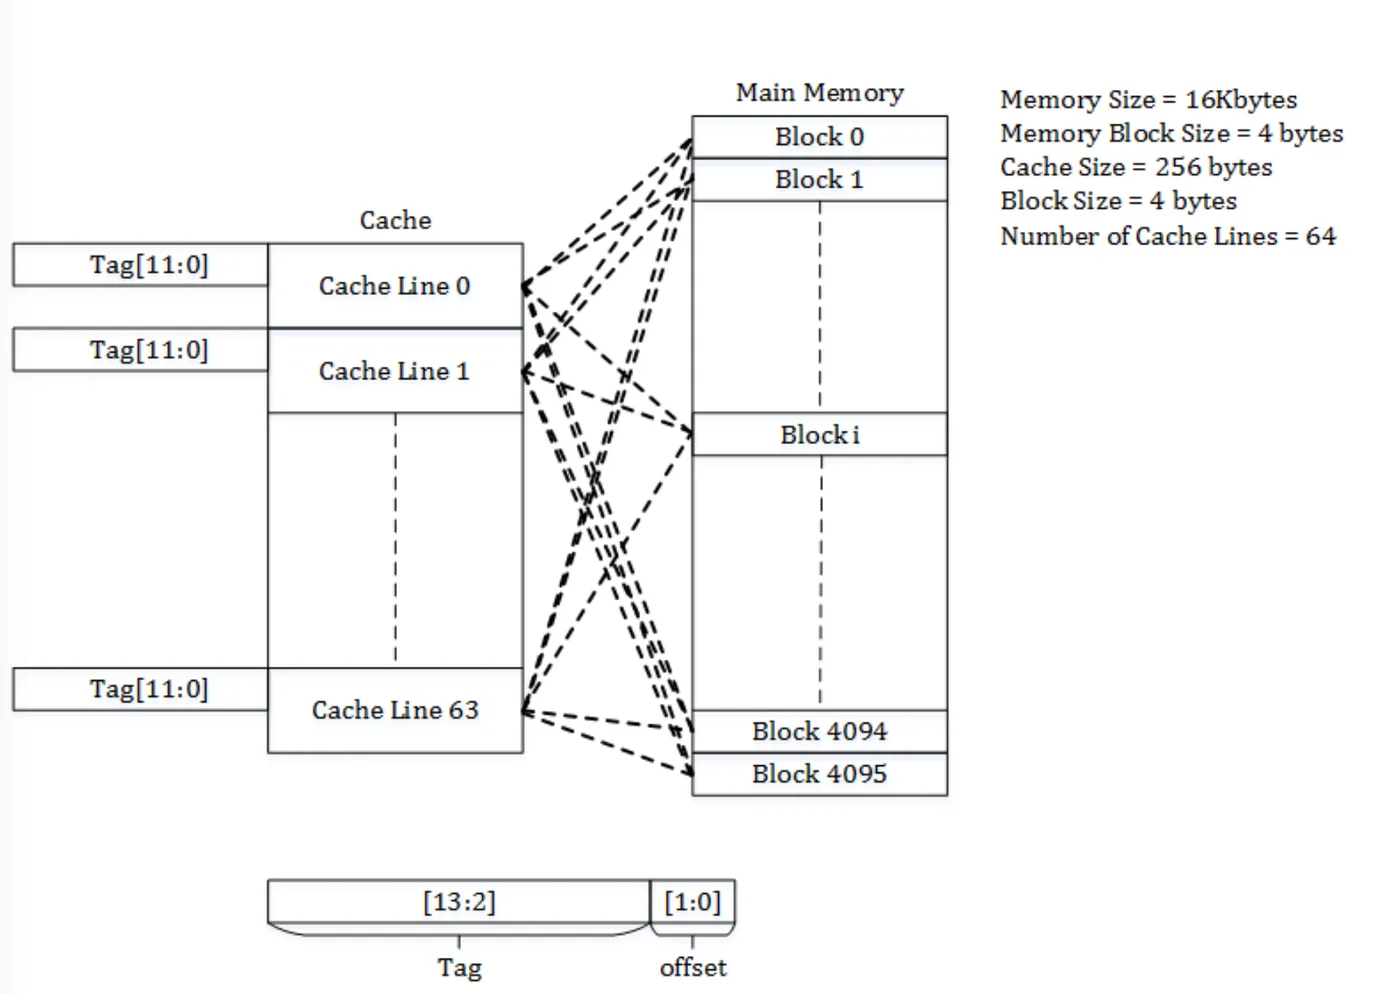
Fully Associative Cache (완전 연관 캐시)
- Direct Mapped와 반대로, 모든 캐시 엔트리가 하나의 세트에 속한다.
- 세트가 하나뿐이므로 세트 인덱스가 없고, 메모리 블록은 어느 캐시 라인에나 들어갈 수 있다.
- 메모리 주소의 태그 필드와 일치하는 태그를 가진 캐시 엔트리가 있는지 모두 확인한다.
Set Associative Cache
- Direct Mapped Cache와 Fully Associative Cache의 장점을 결합한 방식이다.
- 세트가 여러 개이고, 세트마다 여러 개의 캐시 엔트리를 가진다.
- 메모리 주소의 세트 인덱스로 세트를 찾은 뒤, 그 세트의 엔트리들 가운데 태그가 일치하는 것을 탐색한다.
지역성
지역성(Locality)은 데이터 접근이 시간적 혹은 공간적으로 가깝게 일어나는 성질이다. 기억장치 안의 정보를 균일하게 참조하는 것이 아니라, 어느 한 순간에 특정 부분을 집중적으로 참조한다. 캐시는 이 성질 덕분에 효과가 있다.
- 시간적 지역성: 한 번 접근한 데이터는 가까운 미래에 다시 접근할 가능성이 높다.
- 공간적 지역성: 접근한 데이터와 가까운 주소의 데이터에 접근할 가능성이 높다.
CPU 캐시나 디스크 캐시는 한 메모리 주소에 접근할 때 그 주소뿐 아니라 해당 블록 전체를 캐시에 가져온다. 따라서 메모리 주소를 오름차순이나 내림차순으로 접근하면, 이미 캐시에 들어 있는 같은 블록의 데이터를 쓰게 되어 캐시 효율이 크게 높아진다.
이차원 배열을 가로/세로로 탐색할 때의 성능 차이
- 이차원 배열은 행(가로) 단위로 순차적으로 메모리에 적재된다.
- 가로로 탐색하면 한 번 가져온 블록 안의 데이터를 연달아 사용하므로 캐시로 빠르게 접근한다.
- 세로로 탐색하면 매번 가져온 블록이 아닌 다른 블록을 참조하게 되어 시간이 더 오래 걸린다. 배열이 크면 몇 배의 차이가 날 수 있다.
애플리케이션 캐시의 일관성
캐시는 CPU뿐 아니라 애플리케이션에서도 같은 원리로 쓰이며, 이때는 원본 데이터와 캐시를 어떻게 일치시킬지가 문제가 된다.
Cache Invalidation
요청에 대해 캐시 데이터를 사용할지 말지를 결정하고, 항상 최신 데이터를 반환하도록 하는 과정이다.
- Expiration Time: 캐시의 유효 시간을 정해 둔다.
- Freshness Caching Verification: 별도의 검증 절차로 캐시가 유효한지 확인한다. 원본 데이터가 수정된 시간과 캐시가 생성된 시간을 비교해 판별한다.
- Active Application Invalidation: 데이터를 수정하는 코드가 수행될 때마다 백엔드에서 연관된 캐시를 무효화한다. 캐시를 세밀하게 관리할 수 있어, 잘 설계하면 가장 효율이 좋다.
로컬 캐시와 분산 환경
로컬 캐시는 구현이 쉽지만, scale-out된 분산 환경에서는 애플리케이션 서버마다 서로 다른 캐시 데이터를 갖는 일관성 문제가 생길 수 있다. 그래서 Redis처럼 모든 서버가 함께 바라보는 캐시 저장소를 둔다. 서버 간에 캐시를 동기화할 필요가 없어진다.