
프로세스 주소 공간과 Stack이 높은 주소부터 할당되는 이유
Stack·Heap·Data·Text 영역의 역할과 Stack이 Heap보다 빠른 이유, Stack이 높은 주소에서 자라는 이유를 정리한다.
시리즈 · 운영체제5 / 18
- 운영체제의 유형
- System Call과 Dual Mode
- 인터럽트와 폴링
- 프로세스와 PCB, 프로세스의 상태 변화
- 프로세스 주소 공간과 Stack이 높은 주소부터 할당되는 이유
- 스레드: 사용자·커널 수준 스레드와 Thread Pool, Fork-Join
- Context Switching
- 프로세스 스케줄링: 단계와 알고리즘
- Thread Scheduling: 경합 범위 PCS와 SCS
- 경쟁 상태와 상호 배제: Thread Safe, 데커·피터슨 알고리즘
- 뮤텍스와 세마포, 모니터
- 교착 상태: 발생 조건과 해결 방법
- 메모리 계층 구조와 캐시 메모리
- 메모리 관리: 주소 바인딩과 연속 메모리 할당
- 가상 메모리: Paging과 Segmentation, TLB
- 요구 페이징과 페이지 교체 알고리즘, Thrashing
- File Descriptor와 File System, I-Node
- 동기/비동기와 블로킹/논블로킹, I/O Multiplexing
OS 심화 스터디를 하며 기본 개념과, 공부하다 궁금했던 점에 대한 답을 정리한다.
프로세스 주소 공간
프로세스가 메모리를 할당받으면 이 공간을 일정한 구조로 나누어 관리한다. 이를 프로세스 주소 공간이라고 한다.
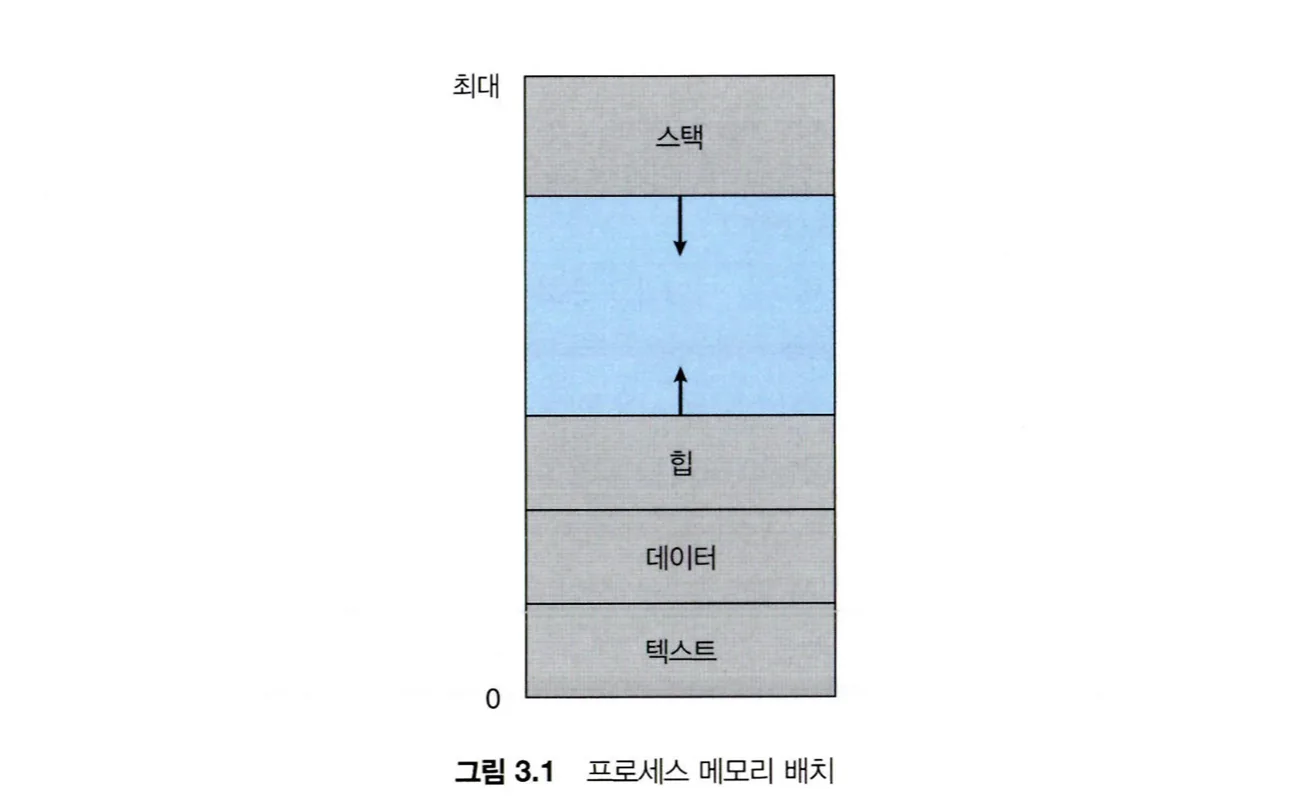
Stack
- 함수 호출과 관계되는 지역 변수와 매개변수가 저장된다.
- 함수 호출과 함께 할당되고 호출이 완료되면 소멸한다.
- 재귀 호출이 너무 깊거나 지역 변수가 너무 많아 Stack 영역을 초과하면 Stack Overflow가 발생한다.
- 일반적으로 높은 주소에서 낮은 주소로 할당된다. (왜 그런지는 아래에서 다룬다.)
Heap
- 런타임에 크기가 결정되는 영역이다.
- 사용자가 공간을 동적으로 할당하고 해제한다. (C의
malloc,calloc등) - 주로 객체 같은 참조형 데이터가 할당된다.
Data
전역 변수나 static 변수처럼 프로그램이 사용하는 데이터를 저장한다. 프로그램 시작과 함께 할당되고 종료될 때까지 유지된다. Stack처럼 함수 호출·반환에 따라 사라지면 안 되고, Heap처럼 동적으로 관리할 필요도 없이, 프로세스가 살아 있는 동안 고정된 위치에 있어야 하는 데이터다.
세부적으로는 다음과 같이 나뉜다.
- rodata: 읽기 전용으로 초기화되는 영역 (
const로 선언한 상수) - data: 초깃값이 있는 전역 변수와 static 변수
- BSS(Block Started by Symbol): 초기화되지 않은 전역 변수와 static 변수. 프로세스 시작 시 0으로 채워진다.
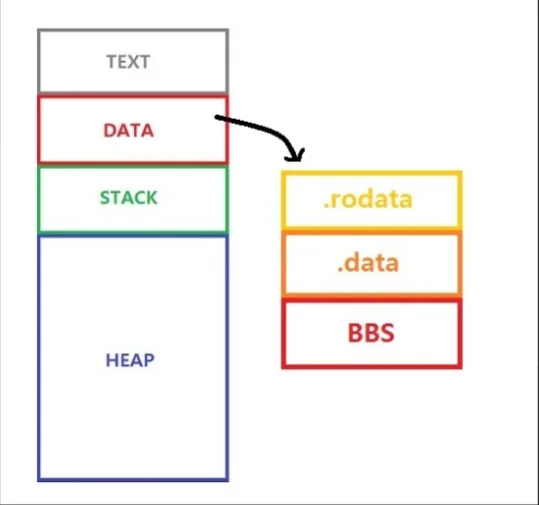
data와 BSS를 왜 나눌까? 초깃값이 없는 변수는 값을 실행 파일에 담아 둘 필요가 없고 크기 정보만 있으면 된다. 따로 구분하면 실행 파일의 크기를 줄일 수 있다.
BSS에 있는 변수에 나중에 값을 대입하면? data 영역으로 옮겨 가지 않고 BSS 영역에 그대로 남는다. 어느 영역에 놓일지는 실행 전에 이미 정해지기 때문이다.
Text (Code)
- CPU가 해석할 수 있는 기계어 코드가 저장된다.
- 프로그램이 수정되면 안 되므로 읽기 전용이다.
어떤 주소가 수정 가능한지는 어떻게 알까
그 주소가 속한 영역의 권한을 확인하면 된다. Text 영역은 읽기 전용이라 수정할 수 없고, data와 BSS 영역은 읽기와 쓰기가 모두 가능하다. 실제 검사는 주소 변환 과정에서 매핑 테이블의 protection bit로 이루어진다. (가상 메모리: Paging과 Segmentation 참고)
Stack과 Heap의 차이
속도
Stack이 Heap보다 훨씬 빠르다.
Stack은 이미 크기가 정해진 메모리다. 별도의 할당 과정 없이 Stack Pointer를 이동시키며(덧셈·뺄셈 연산) 데이터를 저장하고, 사용이 끝난 메모리도 굳이 반납하지 않는다. 포인터만 되돌려 두면 남아 있던 데이터는 다음에 그 공간을 쓸 때 단순히 덮어 쓰인다.
반면 Heap은 런타임에 동적으로 할당되므로, 요청된 chunk의 크기와 현재 메모리의 단편화 상황 등을 고려해 할당과 해제를 관리해야 한다. 또 스레드 간에 공유되는 영역이라 동기화를 거쳐야 해서 Stack보다 느리다.
크기
- Heap: 런타임에 동적으로 할당되고 해제되며 크기가 변한다.
- Stack: 생성될 때 크기의 한도가 정해지고, 이후에는 바뀌지 않는다.
Stack에는 지역 변수와, Heap에 있는 실제 객체를 가리키는 참조(주소)가 저장된다. 실제 객체는 Heap에서 관리되므로 Stack은 Heap보다 훨씬 작아도 괜찮다.
Thread의 주소 공간
Thread는 각자의 Stack만 따로 가지고, 나머지 영역(Code, Data, Heap)은 모두 공유한다.
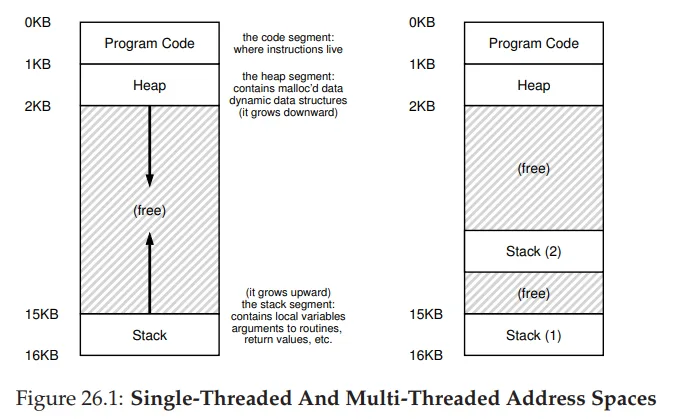
Data 영역과 Stack 영역이 구분되어 있기 때문에, 스레드는 자신만의 Stack을 가지면서도 Data 영역을 공유해 메모리를 절약할 수 있다.
운영체제의 많은 주제가 Thread를 다루기 때문에 이 구조는 매우 중요하다. 프로세스와 스레드의 Context Switching 비용이 다른 것도 여기서 나온다.
Stack은 왜 높은 주소부터 할당될까
결론부터 말하면 꼭 높은 주소부터 할당해야 하는 것은 아니다. 스택을 낮은 주소부터 할당하는 아키텍처도 있다고 한다.
중요한 것은 Stack과 Heap이 서로 마주 보는 방향으로 자란다는 점이다. 두 영역이 겹치는 것을 막으면서, 각자가 충분한 주소 공간을 확장해 쓸 수 있게 하기 위해서다.
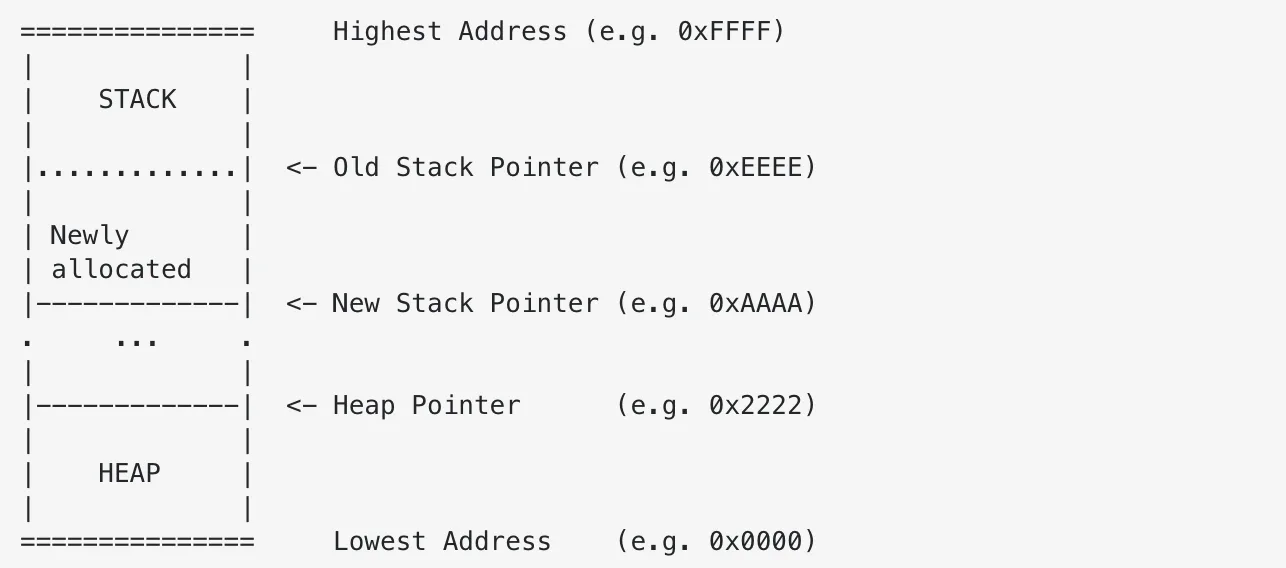
커널 영역을 침범하지 않기 위해서라는 등 여러 설명을 보았지만, 이 이유가 가장 타당해 보인다.