
그래프: 인접 행렬과 인접 리스트
그래프의 개념과 인접 행렬·인접 리스트 구현의 장단점, 연산별 시간 복잡도 차이, 트리와의 관계를 정리한다.
시리즈 · 자료구조 · 알고리즘9 / 13
- 시간 복잡도와 공간 복잡도
- 재귀 함수와 꼬리 재귀 최적화
- 연결 리스트(Linked List)
- 스택과 큐: 원형 큐 구현과 덱
- 해시 테이블: 해시 함수와 충돌 처리
- 트리와 이진 탐색 트리
- 힙(Heap)과 우선순위 큐
- 균형 이진 탐색 트리: AVL, Red-Black, B-Tree
- 그래프: 인접 행렬과 인접 리스트
- 최단 경로 알고리즘: BFS, 다익스트라, 벨만-포드, 플로이드-워셜, A*
- 최소 신장 트리(MST): Kruskal, Prim, Union-Find
- 정렬 알고리즘: 퀵·병합·기수 정렬부터 Timsort까지
- Thread-Safe 자료구조: Python GIL과 Java ConcurrentHashMap
그래프
연결되어 있는 원소 간의 관계를 나타낸 자료구조로, 정점(노드)과 간선으로 이루어진다.
- 완전 그래프: 모든 정점이 서로 연결되어 있는 그래프
- 부분 그래프: 어떤 그래프의 정점과 간선 일부로 이루어진 그래프
- 가중 그래프: 간선에 가중치가 있는 그래프
구현 방법
아래에서 N은 정점의 수, E는 간선의 수이다.
인접 행렬
N × N 행렬에 간선의 정보를 저장하는 방법이다. matrix[i][j]에 정점 i와 j 사이의 간선 유무(또는 가중치)를 기록한다.
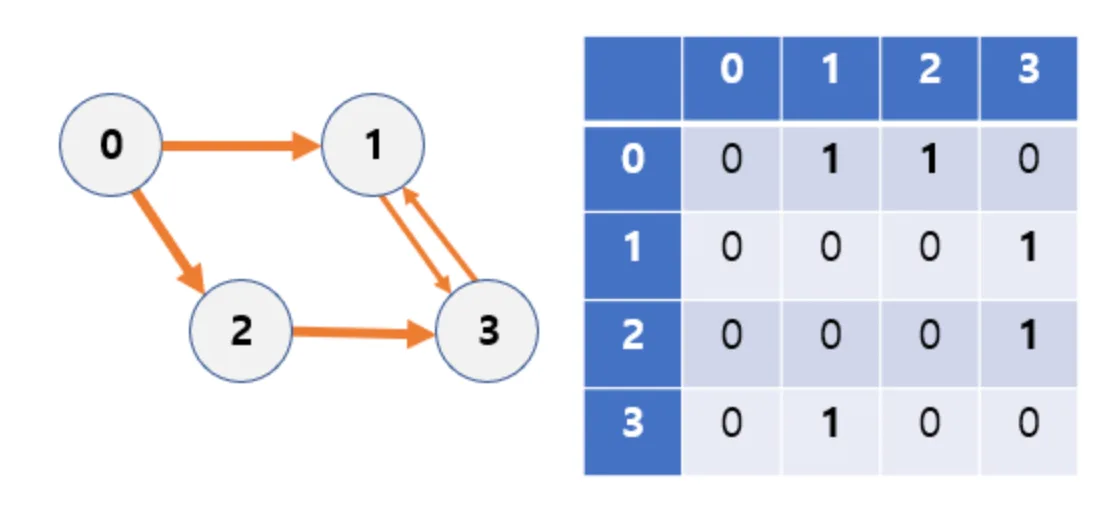
장점
- 두 정점 사이의 간선 확인과 간선 추가 / 삭제가 O(1)로 빠르다.
단점
- 간선의 개수와 상관없이 공간 복잡도가 O(N²)이다.
- 정점의 추가 / 삭제가 느리다. 행렬을 다시 만들어야 하므로 O(N²)이다.
- 그래프의 모든 간선을 확인하려면 O(N²)이 걸린다.
정점의 개수가 상대적으로 적고 간선이 많은 밀집 그래프(Dense Graph) 에 적합하다.
인접 리스트
정점마다 자신과 연결된 정점들의 목록을 리스트로 저장하는 방법이다.
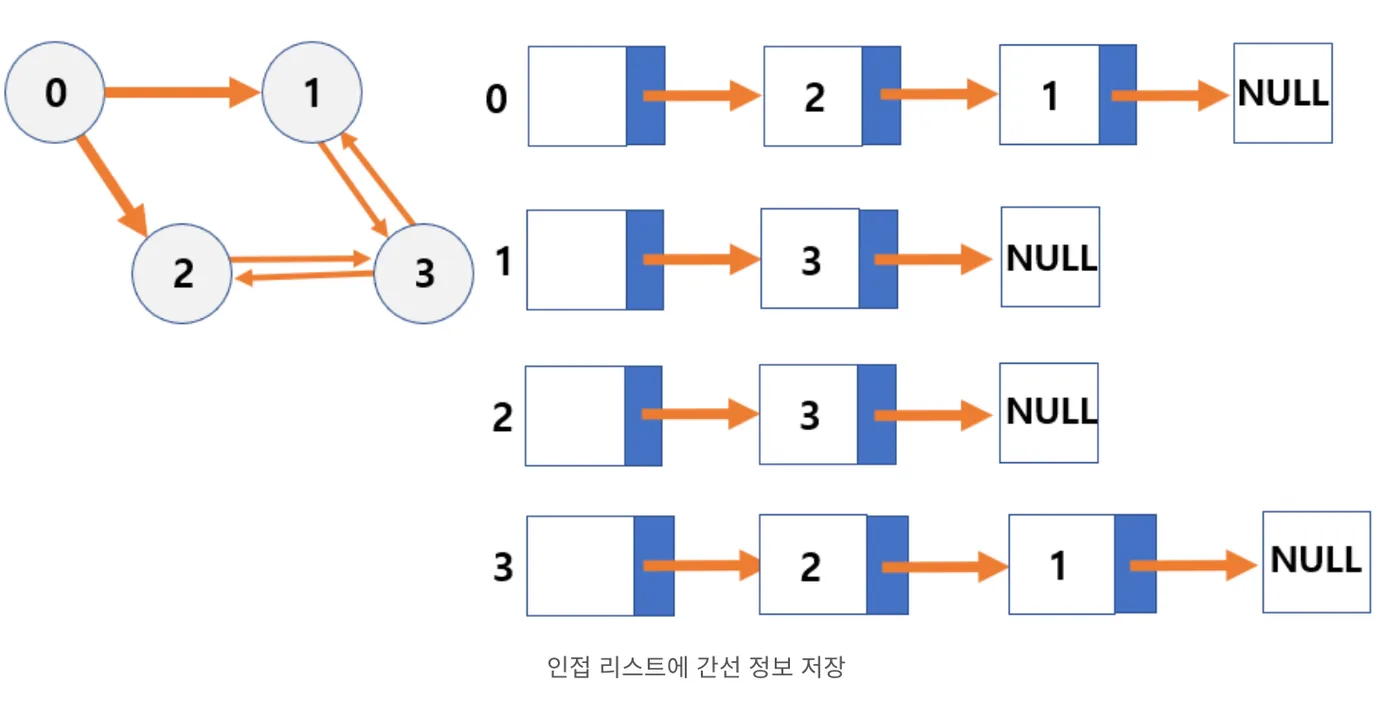
장점
- 존재하는 간선만 저장하므로 메모리 효율이 좋다.
- 특정 정점에 인접한 정점들을 바로 찾을 수 있다.
- 정점의 추가가 빠르다.
- 새로운 간선을 O(1)에 추가할 수 있다.
- 그래프의 모든 간선을 확인하는 데 O(N + E)가 걸린다.
단점
- 두 정점 사이에 간선이 있는지 확인하려면 리스트를 따라가야 하므로 오래 걸린다.
정점의 개수가 많고 간선이 상대적으로 적은 희소 그래프(Sparse Graph) 에 적합하다.
연산별 시간 복잡도 비교
| 연산 | 인접 행렬 | 인접 리스트 |
|---|---|---|
| 두 정점이 연결되어 있는지 확인 | O(1) | O(N) |
| 한 정점에 연결된 모든 정점 찾기 | O(N) | O(해당 정점의 간선 수) |
| 모든 간선 확인 | O(N²) | O(N + E) |
| 공간 | O(N²) | O(N + E) |
한 정점에 연결된 정점을 찾을 때 인접 행렬은 간선이 적어도 무조건 한 행 전체를 확인해야 하므로, 이 연산은 인접 리스트가 더 효율적이다.
정점이 N개, 간선이 N³개라면 어떻게 구현하는 것이 좋을까?
간선의 수가 정점의 수에 비해 매우 많은 경우이다. 인접 리스트의 메모리 이점이 사라지므로, 간선의 확인과 삽입 / 삭제가 O(1)인 인접 행렬로 구현하는 것이 효율적이다.
사이클이 없는 그래프는 모두 트리일까
사이클은 한 정점에서 출발해 간선을 따라 돌아다니다가 다시 출발점으로 돌아올 수 있는 경로를 말한다.
사이클이 없다고 해서 모두 트리인 것은 아니다. 아래 그래프는 방향 간선을 따라가도 출발점으로 돌아올 수 없으므로 사이클이 없지만, 한 정점으로 들어오는 간선이 두 개여서 부모가 둘인 셈이므로 트리가 아니다. 또한 사이클이 없더라도 그래프가 여러 조각으로 떨어져 있으면 트리가 아니다.
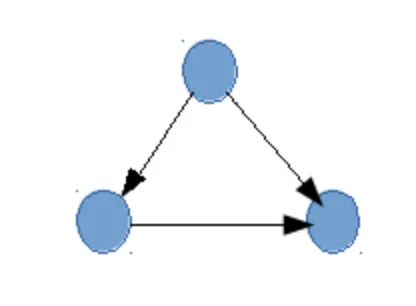
트리가 되려면 사이클이 없으면서 모든 정점이 연결되어 있어야 하고, 루트를 제외한 모든 정점의 부모가 하나여야 한다.