
해시 테이블: 해시 함수와 충돌 처리
해시 함수 설계 방법과 로드 팩터, 체이닝·오픈 어드레싱·이중 해싱 등 해시 충돌 처리 방식을 정리한다.
시리즈 · 자료구조 · 알고리즘5 / 13
- 시간 복잡도와 공간 복잡도
- 재귀 함수와 꼬리 재귀 최적화
- 연결 리스트(Linked List)
- 스택과 큐: 원형 큐 구현과 덱
- 해시 테이블: 해시 함수와 충돌 처리
- 트리와 이진 탐색 트리
- 힙(Heap)과 우선순위 큐
- 균형 이진 탐색 트리: AVL, Red-Black, B-Tree
- 그래프: 인접 행렬과 인접 리스트
- 최단 경로 알고리즘: BFS, 다익스트라, 벨만-포드, 플로이드-워셜, A*
- 최소 신장 트리(MST): Kruskal, Prim, Union-Find
- 정렬 알고리즘: 퀵·병합·기수 정렬부터 Timsort까지
- Thread-Safe 자료구조: Python GIL과 Java ConcurrentHashMap
해시 테이블
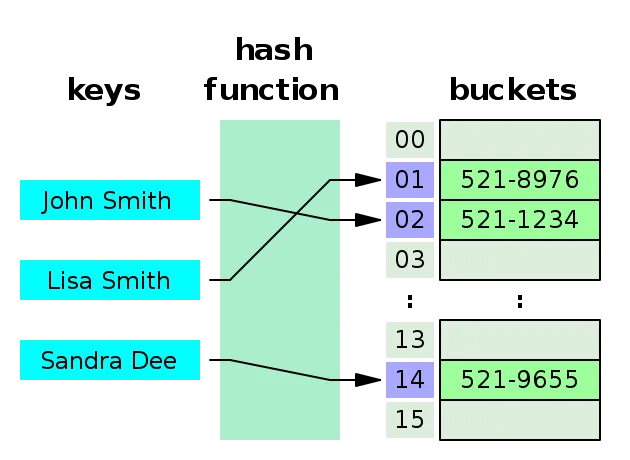
해시 함수로 키를 해시값으로 매핑하고, 이 해시값을 인덱스(주소)로 삼아 데이터를 키와 함께 저장하는 Key-Value 형태의 자료구조이다.
키로 저장 위치를 바로 계산할 수 있어 삽입, 삭제, 검색이 모두 평균 O(1)이다. 데이터 양과 관계없이 조회가 빠르며, 파이썬의 딕셔너리가 해시 테이블로 구현되어 있다.
해시 함수와 충돌
해시 함수는 임의 크기의 키를 고정된 길이의 해시값으로 바꿔 주는 함수이고, 이 과정을 해싱(Hashing)이라고 한다.
ABC    -> A1
1234BC -> CV
AF32B  -> D5
서로 다른 키가 같은 해시값을 갖는 경우를 해시 충돌이라고 한다. 키의 범위는 사실상 무한하고 테이블 크기는 유한하므로 충돌은 피할 수 없고, 해시 테이블은 충돌을 반드시 처리해야 한다.
충돌이 적은 해시 함수를 설계하는 방법
Division Method
가장 기본적인 해시 함수이다. 숫자로 된 키를 테이블 크기 N으로 나눈 나머지를 해시값으로 쓴다.
h(k) = k mod N- 간단하고 연산이 빠르다.
- 해시값이 한쪽으로 몰리는 것을 줄이기 위해 테이블 크기 N은 소수로 정하는 것이 좋다.
Multiplication Method
키에 0과 1 사이의 상수를 곱한 뒤 소수 부분에 테이블 크기를 곱해 해시값을 얻는 방식이다. 테이블 크기를 소수로 맞출 필요가 없다.
Universal Hashing
여러 개의 해시 함수 집합을 만들어 두고, 그중 하나를 무작위로 선택해 사용하는 방식이다. 특정 입력 패턴이 하나의 해시 함수에서 계속 충돌을 일으키는 상황을 확률적으로 피할 수 있다.
로드 팩터
저장된 데이터 개수 n을 버킷 개수 k로 나눈 값이다.
load factor = n / k로드 팩터가 커진다는 것은 버킷 수에 비해 데이터가 많아진다는 뜻이다. 빈 공간이 줄어 충돌이 늘어나므로 해시 테이블의 성능이 점점 떨어진다.
충돌 처리 방식
Chaining
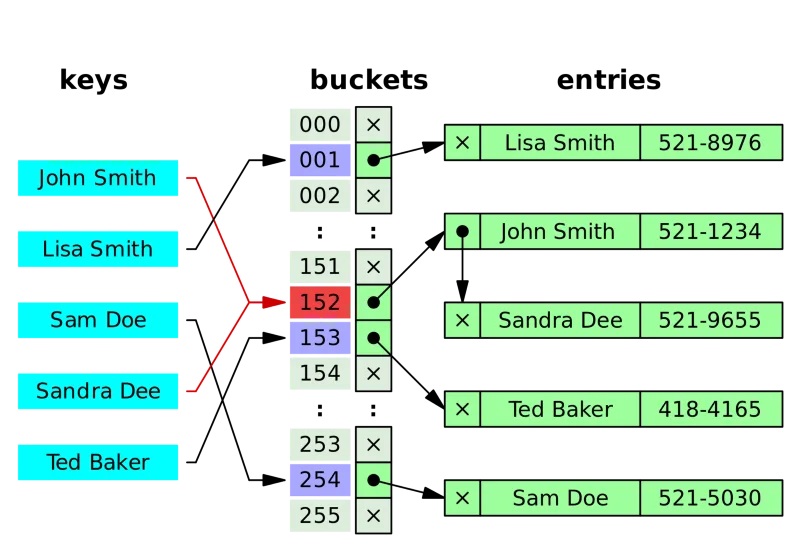
충돌이 일어나면 같은 버킷의 항목들을 연결 리스트로 연결한다.
- 장점: 충돌에 대비해 공간을 미리 많이 잡아 둘 필요가 없다. 충돌이 나면 그때 노드를 만들어 연결하면 된다.
- 단점: 한 버킷에 항목이 많이 연결되면 검색 효율이 떨어진다.
Open Addressing
충돌이 일어나면 탐사(probing)를 통해 비어 있는 다른 버킷을 찾아 저장한다.
- 선형 탐사: 해시값에서 고정 폭(보통 1칸)씩 건너뛰며 빈 버킷을 찾는다.
- 제곱 탐사: 고정 폭이 아니라 1칸, 4칸, 9칸, 16칸처럼 제곱수만큼 떨어진 버킷을 찾는다.
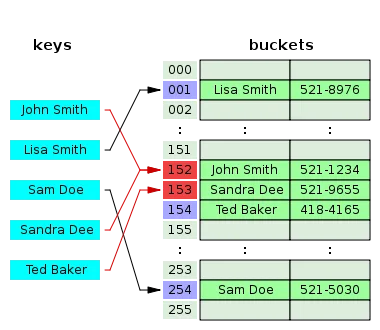
모든 데이터를 테이블 안에 저장하므로, 해시값이 같은 키가 많이 들어오면 공간을 넉넉히 확보해 두어야 한다. 로드 팩터가 1에 가까울수록 빈 버킷이 거의 없어 탐사가 길어지고 성능이 크게 떨어진다.
Double Hashing
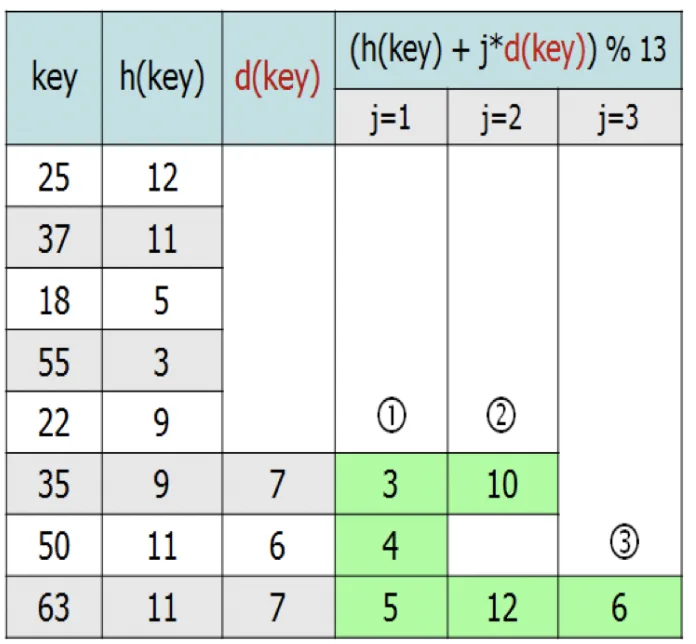
오픈 어드레싱의 탐사 방법 중 하나로, 해시 함수 h에서 충돌이 나면 두 번째 해시 함수 d로 건너뛸 폭을 정한다. 키마다 탐사 폭이 달라지므로 충돌한 키들이 한곳에 뭉치는 현상이 줄어든다.
언어별 구현
- Python: 오픈 어드레싱을 사용한다.
- Java: 체이닝을 사용한다. Java 8부터
HashMap은 한 버킷에 항목이 많아지면 연결 리스트 대신 트리(레드-블랙 트리)로 바꿔 검색 성능을 보완한다.
오픈 어드레싱에서 생기는 의문
충돌이 나서 다른 버킷에 저장된 값은 나중에 어떻게 찾을까?
저장할 때와 같은 순서로 탐사한다. 먼저 해시값 위치로 가서 키를 비교하고, 다르면 같은 규칙으로 다음 버킷을 하나씩 확인하며 찾는다. 빈 버킷을 만나면 해당 키는 없는 것이다.
키를 삭제해 그 버킷이 비면, 충돌 때문에 그 뒤에 저장된 다른 키는 어떻게 찾을까?
삭제한 자리를 그냥 비워 두면 탐사가 거기서 멈춰 뒤의 키를 찾지 못한다. 그래서 “과거에 값이 있었다”는 표시를 따로 남긴다. 예를 들어 버킷마다 값이 들어온 적이 있는지를 기록해 두고, 그런 버킷은 비어 있어도 탐사를 계속한다. 이 표시를 보통 툼스톤(tombstone)이라고 부른다.
Reference
- 파이썬 알고리즘 인터뷰