
최소 신장 트리(MST): Kruskal, Prim, Union-Find
신장 트리와 최소 신장 트리의 개념, Kruskal과 Prim 알고리즘, Union-Find로 사이클을 판별하는 방법을 정리한다.
시리즈 · 자료구조 · 알고리즘11 / 13
- 시간 복잡도와 공간 복잡도
- 재귀 함수와 꼬리 재귀 최적화
- 연결 리스트(Linked List)
- 스택과 큐: 원형 큐 구현과 덱
- 해시 테이블: 해시 함수와 충돌 처리
- 트리와 이진 탐색 트리
- 힙(Heap)과 우선순위 큐
- 균형 이진 탐색 트리: AVL, Red-Black, B-Tree
- 그래프: 인접 행렬과 인접 리스트
- 최단 경로 알고리즘: BFS, 다익스트라, 벨만-포드, 플로이드-워셜, A*
- 최소 신장 트리(MST): Kruskal, Prim, Union-Find
- 정렬 알고리즘: 퀵·병합·기수 정렬부터 Timsort까지
- Thread-Safe 자료구조: Python GIL과 Java ConcurrentHashMap
신장 트리(Spanning Tree)
그래프의 모든 정점을 포함하는 트리이다.
- 모든 정점이 연결되어 있어야 하고 사이클을 포함해서는 안 된다.
- n개의 정점을 정확히 n - 1개의 간선으로 연결한다. 즉 그래프의 최소 연결 부분 그래프이다.
- DFS나 BFS로 탐색하면서 사용한 간선만 모으면 만들 수 있다.
- 하나의 그래프에는 여러 개의 신장 트리가 존재할 수 있다.
최소 신장 트리(Minimum Spanning Tree)
신장 트리 중에서 사용된 간선들의 가중치 합이 최소인 트리이다. 모든 정점을 가장 적은 수의 간선과 가장 적은 비용으로 연결한다.
Kruskal 알고리즘
간선을 중심으로 하는 Greedy 알고리즘이다. 각 단계에서 사이클을 이루지 않는 최소 비용 간선을 선택한다.
- 그래프의 간선들을 가중치의 오름차순으로 정렬한다.
- 정렬된 간선 리스트에서 가중치가 낮은 것부터 순서대로 확인한다.
- 사이클을 형성하지 않는 간선이면 선택하고, 사이클을 형성하면 건너뛴다.
- n - 1개의 간선을 선택할 때까지 반복한다.
Union-Find로 사이클 판별하기
간선을 추가했을 때 사이클이 생기는지는 Union-Find로 판별한다. Union-Find는 서로소 집합(Disjoint Set)을 표현하는 자료구조로, 두 가지 연산을 제공한다.
- Union: 서로 다른 두 집합을 하나로 병합한다.
- Find: 원소가 어떤 집합에 속해 있는지(대표 원소가 누구인지) 찾는다.
Kruskal에서의 동작은 다음과 같다.
- 처음에는 모든 정점이 각자의 집합이다: {1}, {2}, {3}, {4}
- 가중치가 가장 작은 간선(1 - 2)을 선택한다. 두 정점이 다른 집합이므로 Union 연산으로 합친다. 2의 부모가 1이 된다: {1, 2}, {3}, {4}
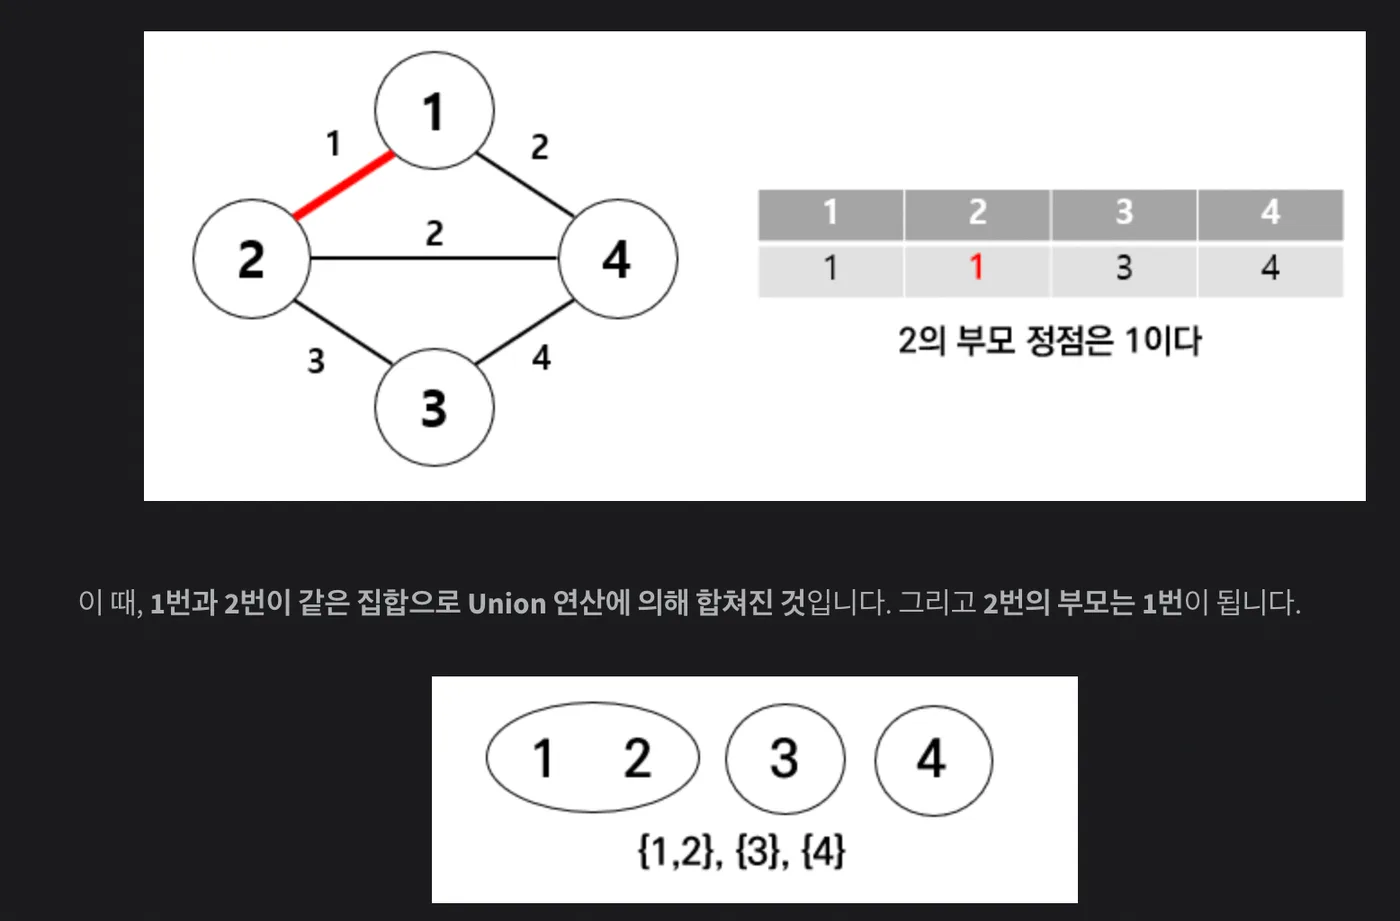
- 같은 방식으로 4의 부모도 1이 된다.
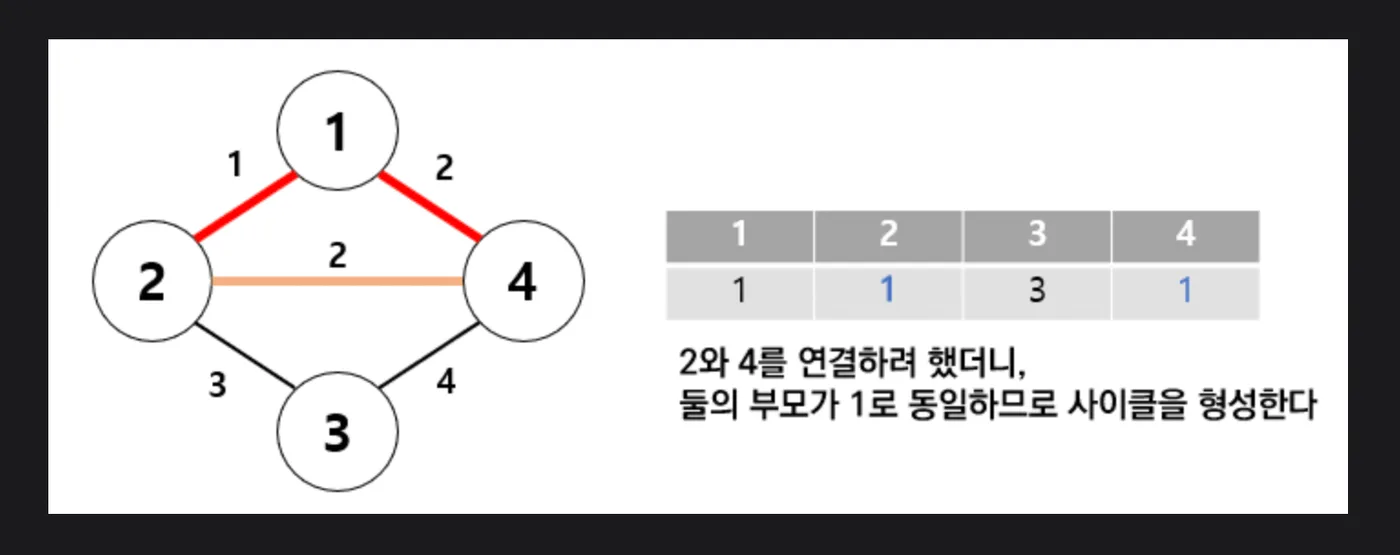
- 이제 2와 4를 연결하려고 Find 연산을 하면 둘 다 대표 원소가 1이다. 같은 집합에 속해 있으므로 이 간선을 추가하면 사이클이 생긴다. 따라서 선택하지 않는다.
Union-Find는 경로 압축(Path Compression) 과 Union by Rank로 최적화한다. 경로 압축은 Find를 하면서 거쳐 간 노드들을 대표 원소에 직접 연결하는 것이고, Union by Rank는 높이가 낮은 트리를 높은 트리 밑에 붙이는 것이다. 두 최적화를 적용하면 연산 한 번이 사실상 상수 시간에 가깝다.
Prim 알고리즘
정점을 중심으로, 시작 정점에서 출발해 신장 트리 집합을 단계적으로 확장하는 알고리즘이다.
- 시작 단계에서는 시작 정점만 MST 집합에 속한다.
- MST 집합에 인접한 간선 중 가중치가 가장 낮은 간선을 선택하고, 그 간선으로 연결된 정점을 MST 집합에 넣는다.
- 집합의 원소 개수가 그래프의 정점 개수가 될 때까지 반복한다.
Kruskal vs Prim
| Kruskal | Prim | |
|---|---|---|
| 기준 | 간선 | 정점 |
| 시간 복잡도 | O(E log E) | O(V²), 힙 사용 시 O(E log V) |
| 적합한 그래프 | 간선이 적은 희소 그래프 | 간선이 많은 밀집 그래프 |
- Kruskal: 간선을 오름차순으로 정렬해야 하므로 정렬 알고리즘의 성능에 좌우된다. Union-Find 연산은 상수 시간에 가까우므로, 정렬에 드는 O(E log E)가 전체 시간 복잡도가 된다.
- Prim: 매번 MST 집합과 나머지 집합 사이의 간선을 모두 탐색하면 O(V²)이다. 바이너리 힙으로 우선순위 큐를 구현하면 O(E log V)가 된다.
간선이 적으면 Kruskal, 많으면 Prim이라는데, 간선의 개수는 n - 1개로 동일한 것 아닌가?
n - 1개는 완성된 MST의 간선 수이다. 여기서 말하는 간선의 개수는 MST를 구하려는 원래 그래프에 연결되어 있는 간선의 개수이다. Kruskal은 그래프의 모든 간선을 정렬해야 하므로 간선이 많을수록 불리하다.